 Yongmin Shin
2026.10.02
[ICML2026] 기계론적 해석 적용: 그래프 트랜스포머(TokenGT) 이해
현대 AI 모델은 인간 수준의 문제해결 성능을 해낼 수 있을 정도로 발전해 왔습니다. 이러한 AI의 핵심 메커니즘이라고 하면, 방대한 데이터를 바탕으로 모델이 패턴을 스스로 학습시키도록 하는 알고리즘을 설계하는 데 있습니다. 매우 효과적임에도 불구하고, 여전히 모델 내부의 구조를 사람이 아닌 알고리즘에 의해서 결정된다는 한계가 존재합니다. 따라서 이러한 모델은 본질적으로 사람이 내부 작동 방식을 해석하기 어렵다는 특성을 가집니다. 이에 따라 AI의 발전과 더불어 일반 사용자부터 머신러닝 연구자에 이르기까지 모델의 설명 가능성에 대한 요구가 지속해서 제기되어 왔습니다.
설명 가능한 AI(XAI) 분야는 꾸준히 발전해 왔습니다. 초기에는 입력 데이터에서 결과에 가장 큰 영향을 미친 부분을 히트맵으로 보여주는 기여도 분석(Attribution) 기법이 사용되었고, 이후에는 반사실적 설명(Counterfactuals), 즉 ‘만약 ~라면?’ 유형의 설명을 비롯해 모델의 행동에 대한 근거를 제시하는 다양한 접근법으로 확장되었습니다. 대부분의 XAI 기법이 직관적인 설명을 제공하지만, 그렇다고 해서 그 설명이 모델을 정확하게 반영한다는 뜻은 아니며[1], 모델 내부에서 실제로 어떤 계산이 이루어져 특정 결과로 이어졌는지를 구체적이고 상세하게 설명해 주는 것도 아닙니다.
이러한 한계를 극복하고자 비교적 최근 등장한 XAI의 최전선 연구 분야가 기계론적 해석(Mechanistic Interpretability, 이하 Mech. Interp.)입니다. 이 분야는 특정 계산 경로인 ‘회로(Circuits)’를 복원하여 신경망을 역공학하는 초기 연구[2,3]에서 출발해 중요한 발전을 이루었으며, 현재는 주로 트랜스포머, 나아가 LLM에 초점을 맞추고 있습니다. 대표적인 연구로는 인덕션 헤드(Induction Heads)의 식별[4], 그로킹(Grokking)에 대한 통찰[5], 희소 오토인코더(Sparse Autoencoders)의 활용[6], 자동화된 회로 발견[7], 활성화 패칭(Activation Patching)[8] 등이 있습니다. Mech. Interp.는 신경망을 세밀한 수준에서 이해하고, 더 나아가 최신 LLM의 추상적인 표현 공간까지 의미론적으로 해석할 수 있음을 보여주었습니다[9].
하지만 지금까지 Mech. Interp. 연구의 대부분은 LLM을 이해하는 데 초점을 맞춰 왔습니다. Mech. Interp.의 특성상 각 연구에서 얻은 결과는 대개 분석 대상이 된 특정 모델에 한정되며, 그 대상은 주로 언어 모델이었습니다. 화학 및 생물학 분야에서 분자 데이터를 처리하는 데 자주 사용되는 주요 모델 아키텍처인 그래프 트랜스포머에 Mech. Interp. 기법을 적용한 연구는 거의 이루어지지 않았습니다. 저희가 수행한 “Discovering Mechanisms in Tokenized Graph Transformers” 연구[10]는 이러한 유형의 모델에 Mech. Interp.를 적용하기 위한 첫걸음입니다.
Mech. Interp. 분야에는 매우 활발한 커뮤니티가 형성되어 있으며, Mechanistic Interpretability Workshop은 전 세계 연구자들이 한자리에 모이는 주요 교류의 장 중 하나로 자리 잡았습니다. 이번이 세 번째 워크숍으로, ICML 2024와 NeurIPS 2025에서 열린 이전 행사에 이어 개최되었으며, LG AI연구원은 이 커뮤니티에 저희 연구를 처음으로 발표할 기회를 가졌습니다.
1-1. 배경 및 연구 동기
XAI 기법의 유용성과 이점은 누구를 대상으로 하느냐에 따라 달라집니다. 특히 Mech. Interp.는 신경망을 역공학하는 것을 목표로 하므로, 대상 모델을 매우 세밀한 수준에서 이해할 수 있게 해줍니다. 이는 신경망에 대한 깊이 있는 이해가 필요한 연구자에게 도움이 될 뿐 아니라, 모델이 실제로 학습한 지식을 추출할 수 있게 해줍니다[11]. 이러한 이점은 AI4Science 연구에도 적용됩니다. 특히 이 분야에서는 신경망을 전체적으로 이해하는 것과 신경망으로부터 과학적 지식을 얻는 능력이 모두 필요한 경우가 많기 때문입니다.
이를 위해 Mech. Interp.를 화학 분야에서 사용되는 모델과 데이터에 맞게 적용하려는 연구를 진행하였습니다. 구체적으로는 화학 분자를 표현하는 데 흔히 사용되는 그래프 데이터를 처리하는 모델에 대한 기본적인 이해가 필요합니다. 이 문제는 아직 거의 연구되지 않았으며, 저희는 가능한 한 단순한 설정에서 이 연구를 시작하기로 했습니다. 이에 저희는 이전에 개발한 그래프 트랜스포머 모델 중 하나인 TokenGT[12]를 연구 대상으로 선택했고, 이번 단계에서는 분자 그래프가 아닌 일반 그래프 설정에서 분석했습니다.
1-2. 문제 설정 - TokenGT와 데이터셋
TokenGT와 같은 트랜스포머(구체적으로T5 인코더 계열)가 노드 및 간선 토큰의 시퀀스로 표현된 그래프를 어떻게 처리하는지 살펴보기 위해 먼저 실험에 사용된 설정을 설명하겠습니다. 구체적으로, 무방향·비가중에 노드/간선 특징이 없는 간단한 그래프 데이터셋을 실험 용도에 맞게 생성하여 진행하였습니다. 학습 중에는 각 배치마다 노드 인덱스(ID)를 섞어 모델이 노드 인덱스와 무관하게 그래프를 이해할 수 있도록 학습합니다. 자세한 내용은 그림을 참조해 주세요.
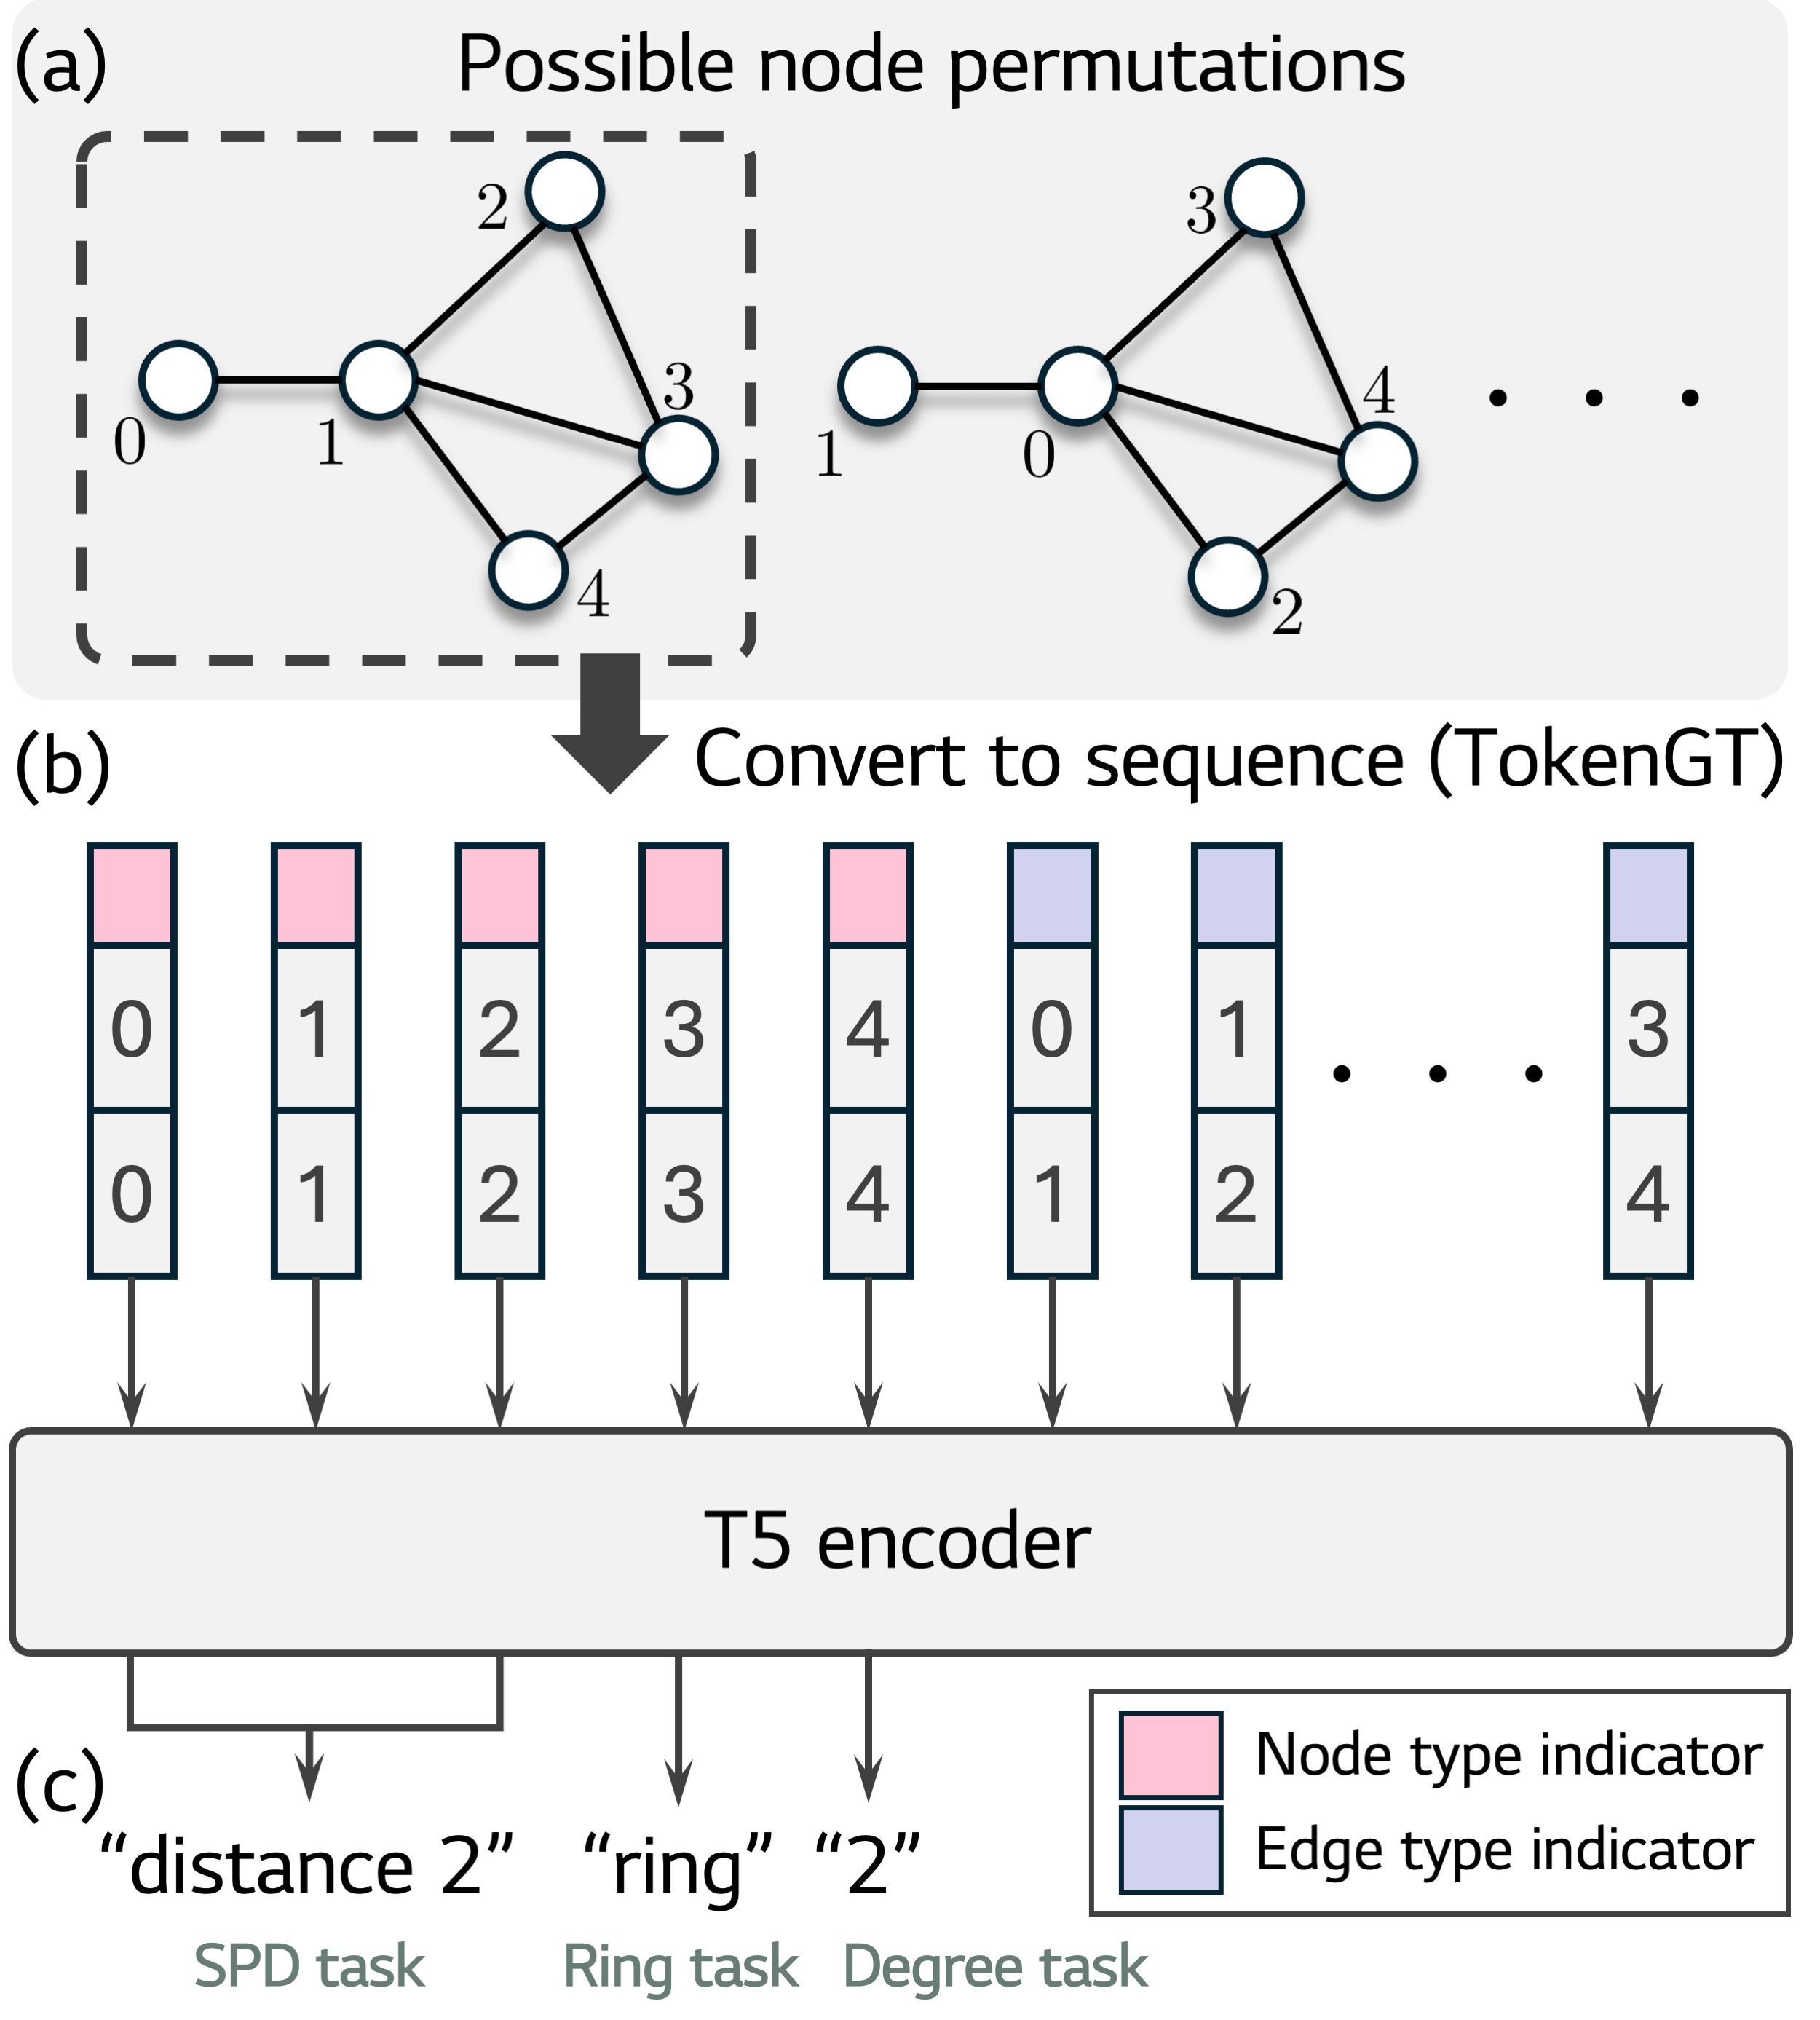
그림 1. (a) 노드 ID를 섞으며 동일한 그래프를 여러 방식으로 표현할 수 있습니다.
(b) 유형(노드/간선) 벡터와 ID 벡터를 결합하여 노드와 간선을 토큰화하는 경우를 고려합니다.
(c) 그래프 태스크를 해결하기 위해 노드 출력에 태스크에 맞는 헤드를 적용합니다. 태스크별로 별도의 모델을 학습하며, 그림에서는 설명하기 용이하게 한꺼번에 표시하였습니다.
저희는 세 가지 기본적인 그래프 태스크를 학습한 모델을 분석합니다: (1) 차수(degree) 계산, (2) 사이클 존재 여부 판별, (3) 최단 경로 거리 계산. 모든 태스크에서 검증 정확도가 거의 100%에 도달하며, 모델이 각 태스크를 성공적으로 학습했음을 확인했습니다.
1-3. 분석 결과
핵심적인 발견 중 하나로는, 세 모델 모두 처음에는 공통적으로 국소(local) 구조와 관련된 계산을 수행한다는 점입니다. 특히 노드 토큰에 각 노드의 차수를 인코딩하는 현상이 가장 뚜렷하게 나타났습니다. 첫 번째 트랜스포머 레이어에서 노드 토큰은 간선의 끝점 ID가 해당 노드의 ID와 일치하는 간선 토큰에 더 강하게 어텐션 값을 계산합니다. 이러한 ID 매칭을 통해 모델은 아키텍처에 그래프 연산이 내장되어 있지 않음에도(그래프 신경망과 달리) 어떤 간선이 각 노드에 연결되어 있는지 파악할 수 있습니다. 저희의 쿼리-키(query-key) 분석 결과, 이러한 메커니즘은 첫 번째 레이어의 거의 모든 어텐션 헤드에 걸쳐 분산되어 있으며 세 가지 태스크별 모델에서 일관되게 나타납니다.
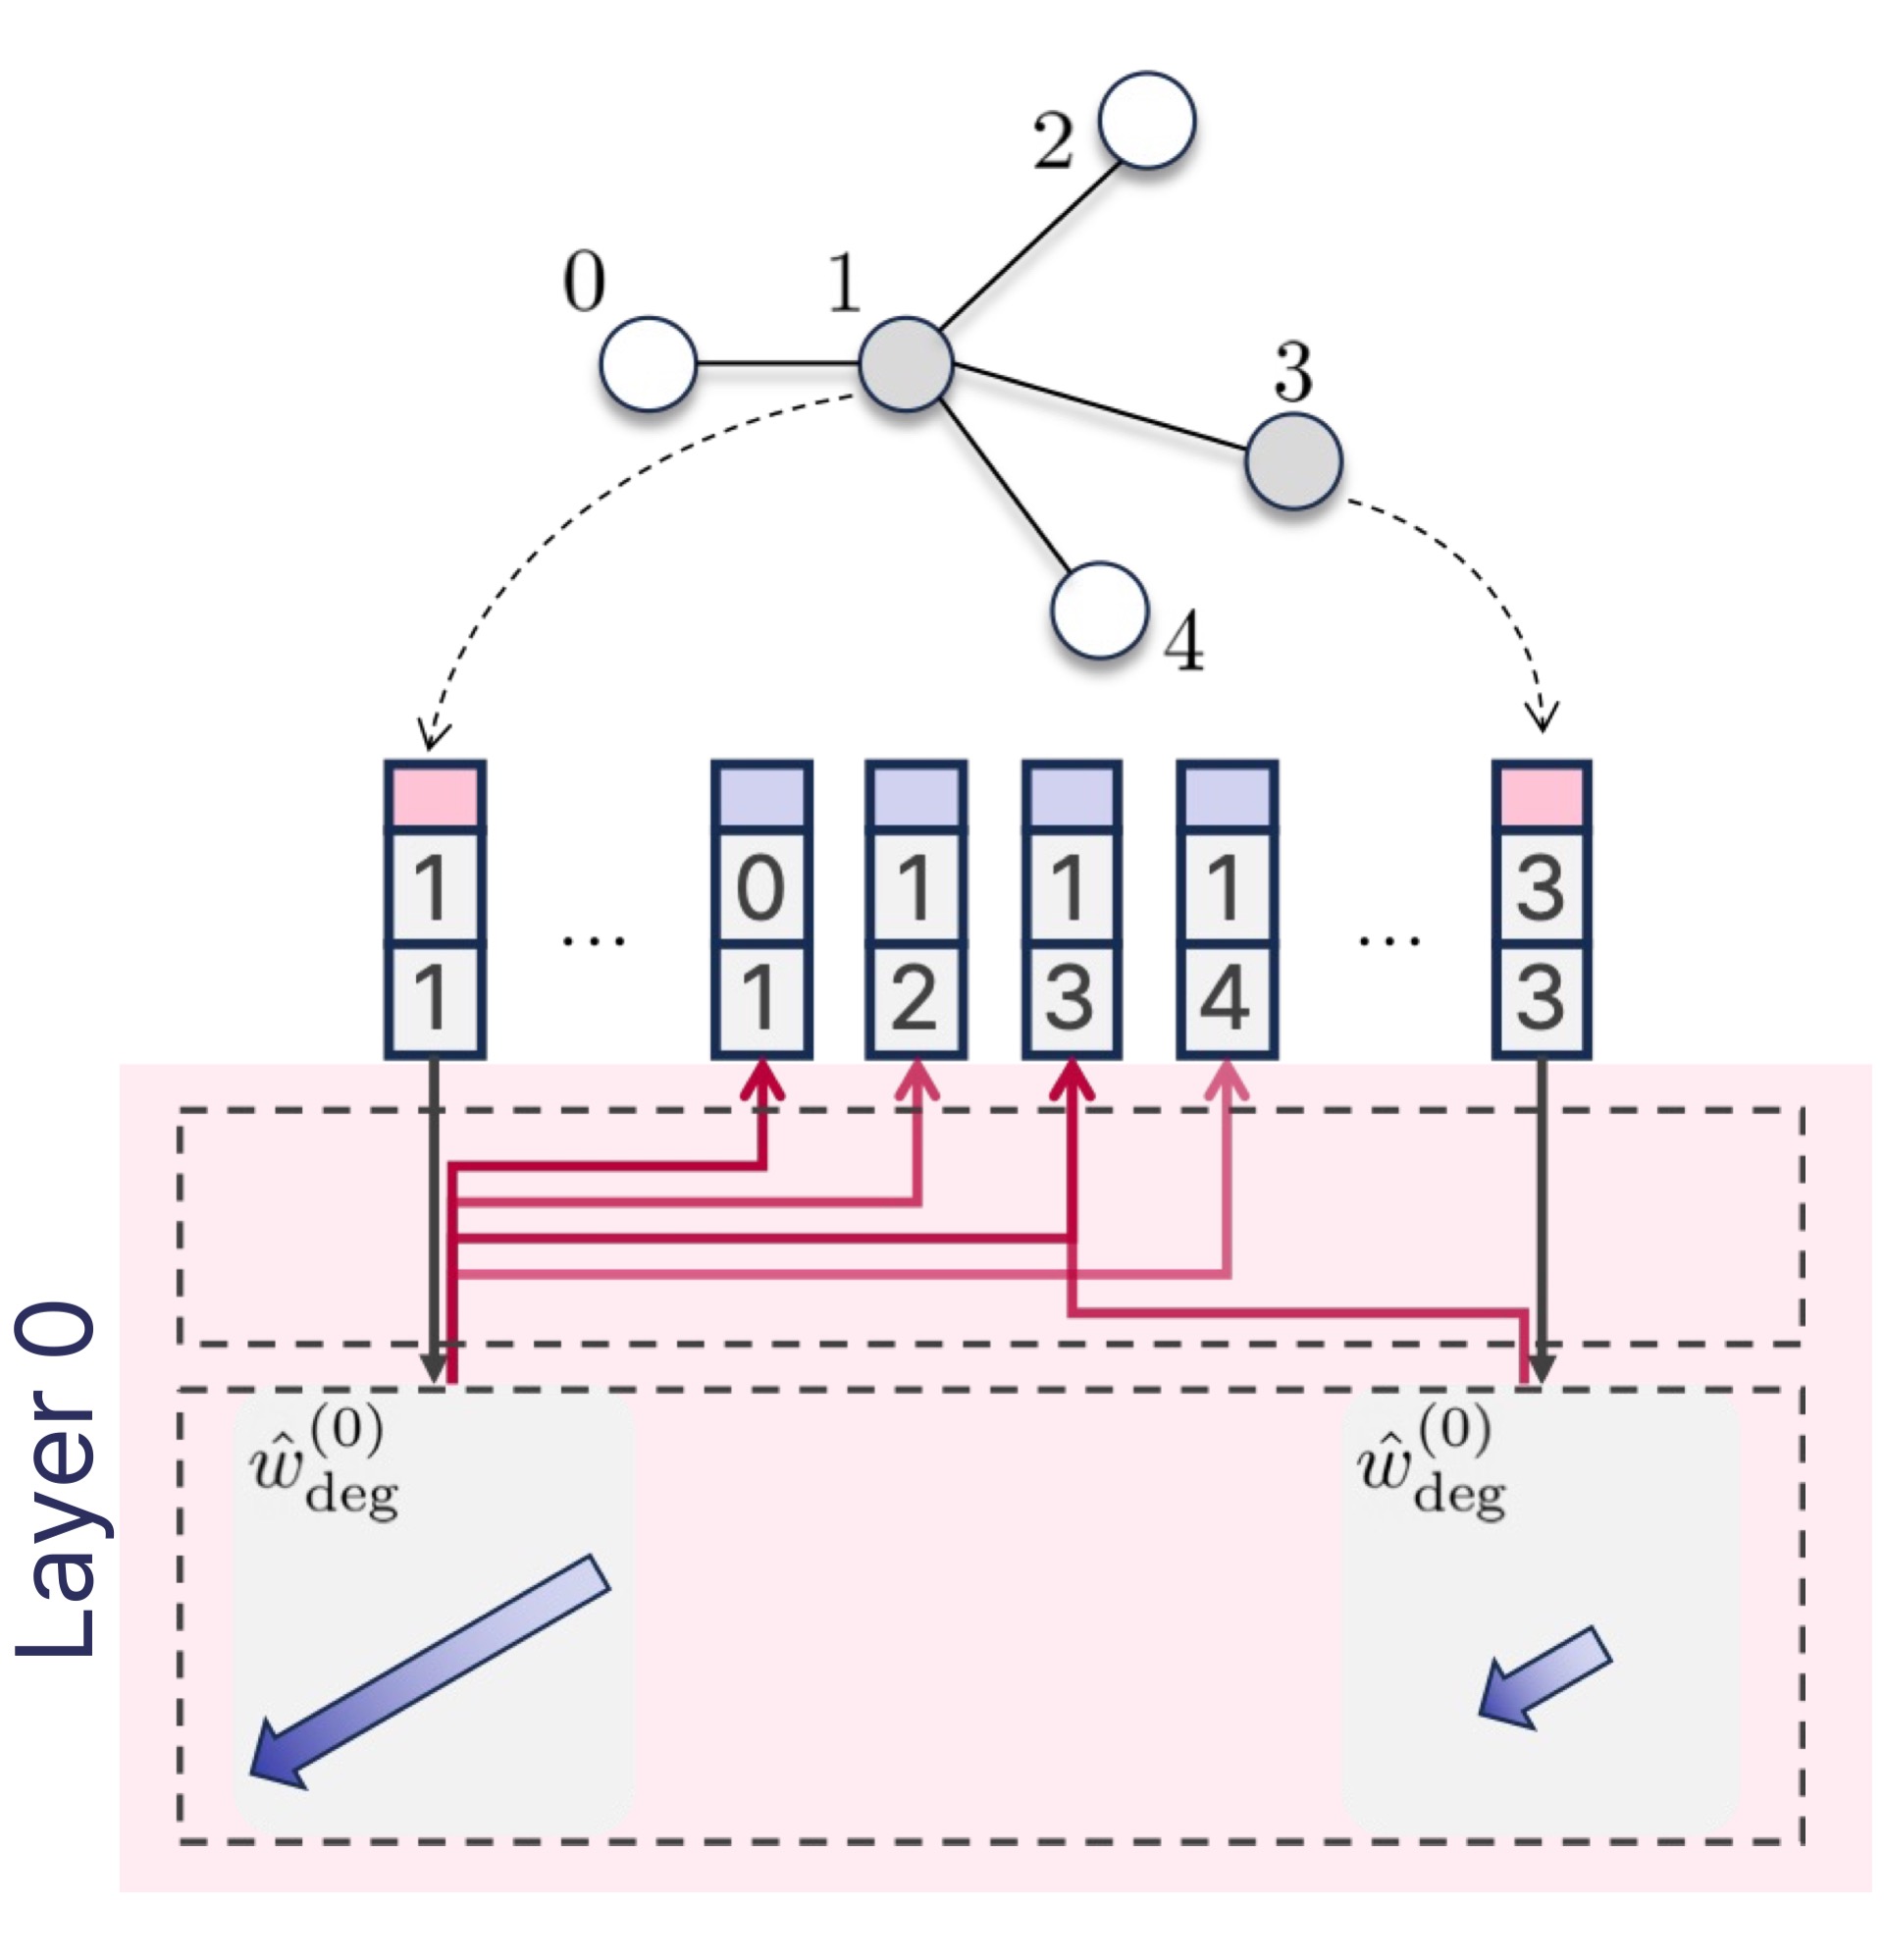
그림 2. 모델이 차수 계산 태스크를 해결하는 방식을 보여주는 그림입니다.
초기 레이어의 어텐션(이 연구에서는 특히 레이어 0)은 간선 토큰(가운데의 파란색 토큰)에서 노드 ID가 나타나는 위치를 식별하고 해당 위치에 어텐션 값을 강하게 줍니다.
그런 다음 차수 정보는 잔차 스트림(residual stream)의 특정 방향에 기록되며, 이때 기록된 벡터의 크기는 실제 차수에 거의 비례합니다(그림 하단의 화살표).
앞서 설명했듯이, 이렇게 해당 노드에 연결된 간선을 찾아내는 과정을 통해 초기에 차수와 유사한 표현이 생성됩니다. 선형 프로브를 활용한 분석 결과, 초기 임베딩에서는 노드 차수를 제대로 복원하기 어렵지만 첫 번째 어텐션 연산 직후에는 노드 차수를 매우 정확하게 읽어낼 수 있게 됩니다. 활성화 패칭을 통한 직접적인 개입을 통해 인과적 증거 또한 알아낼 수 있는데요, 식별된 차수 방향을 따라 잔차 스트림을 수정하면 차수 예측이 달라질 뿐 아니라, 더 복잡한 고리 포함 여부 및 최단 경로 태스크의 성능에도 영향을 미칩니다. 이는 모델들이 각 태스크를 처음부터 독립적으로 학습하는 것이 아니라, 초기에 형성된 동일한 국소 특징을 재사용한다는 점을 시사합니다. 이러한 과정만으로도 차수 계산 문제는 손쉽게 해결됩니다(그림 2 참조). 실험적으로도 추가적인 증거를 확인할 수 있습니다. 노드의 차수가 증가할수록 모델은 해당 노드에 연결된 간선에 더 많은 어텐션을 할당하며, 여러 어텐션 헤드의 결합 출력도 차수에 비례해 차수 관련 방향으로 기록됩니다.
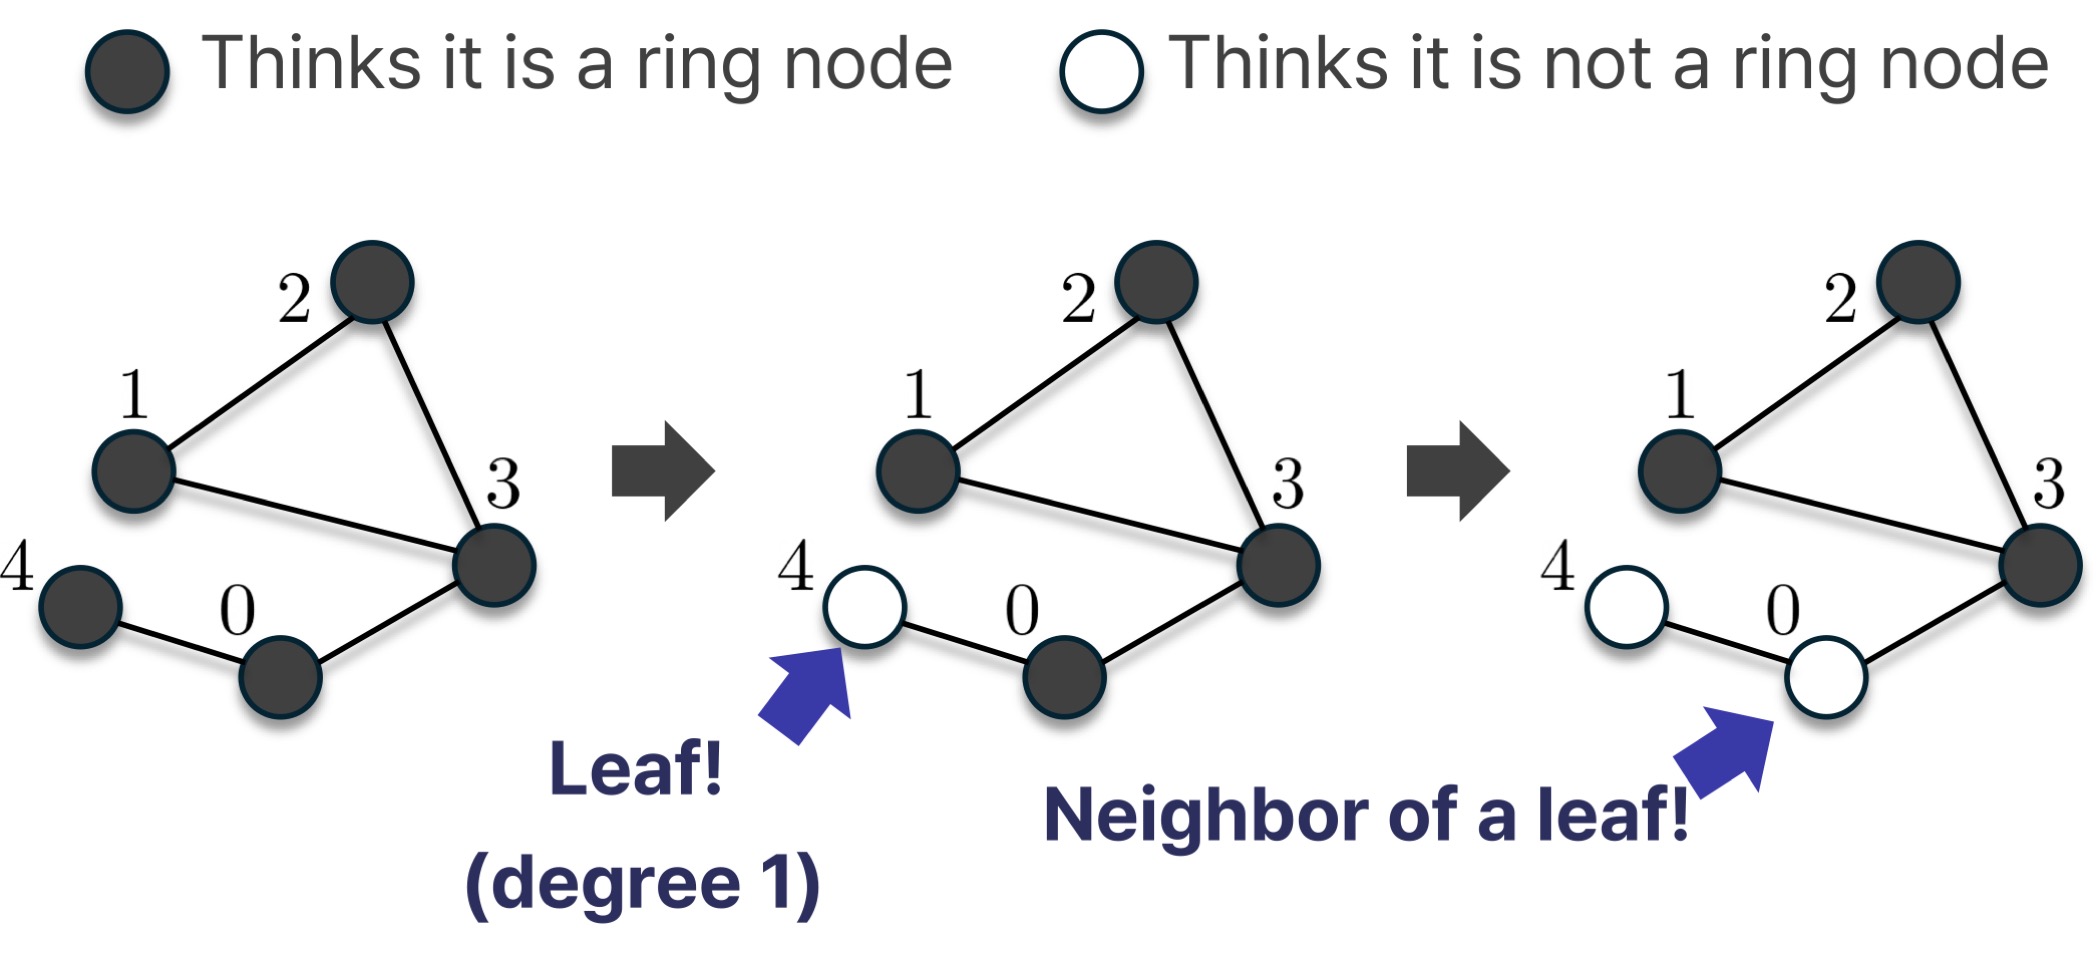
그림 3. 모델이 고리 포함 여부 문제를 해결하는 방식을 보여주는 그림입니다.
모델은 처음에는 모든 노드를 고리 구조의 일부로 판별한 뒤, 해당 노드가 고리에 속하지 않는다는 증거가 모이면 예측을 뒤집습니다.
고리 포함 여부를 판단할 때 모델은 명시적인 사이클 추적 알고리즘을 구현하는 것으로 보이지 않습니다. 대신 어블레이션(ablation – 모델의 주요 모듈을 하나씩 없애면서 변화를 보여주는 방식의 분석) 실험 결과를 더욱 볼 필요가 있습니다(그림 3 참조). 실험 결과, 모델은 처음에 사실상 모든 노드를 고리 클래스에 속하는 것으로 먼저 분류해 놓은 다음, 노드들에 대하여 고리에 속하지 않는 증거들을 차례대로 수집합니다. 리프(leaf) 노드와 리프 노드의 이웃에 관한 정보는 두 번째 레이어의 어텐션 헤드에서 선형 프로브를 통해 읽어낼 수 있습니다. 또한, 두 번째 레이어를 제거하면 주로 고리에 속하지 않는다는 노들에 대한 성능만 저하됩니다. 이는 모델이 범용적인 사이클 검출기를 구축하기보다는 노드가 고리에 속하지 않는다는 증거를 축적한다는 해석을 뒷받침합니다.
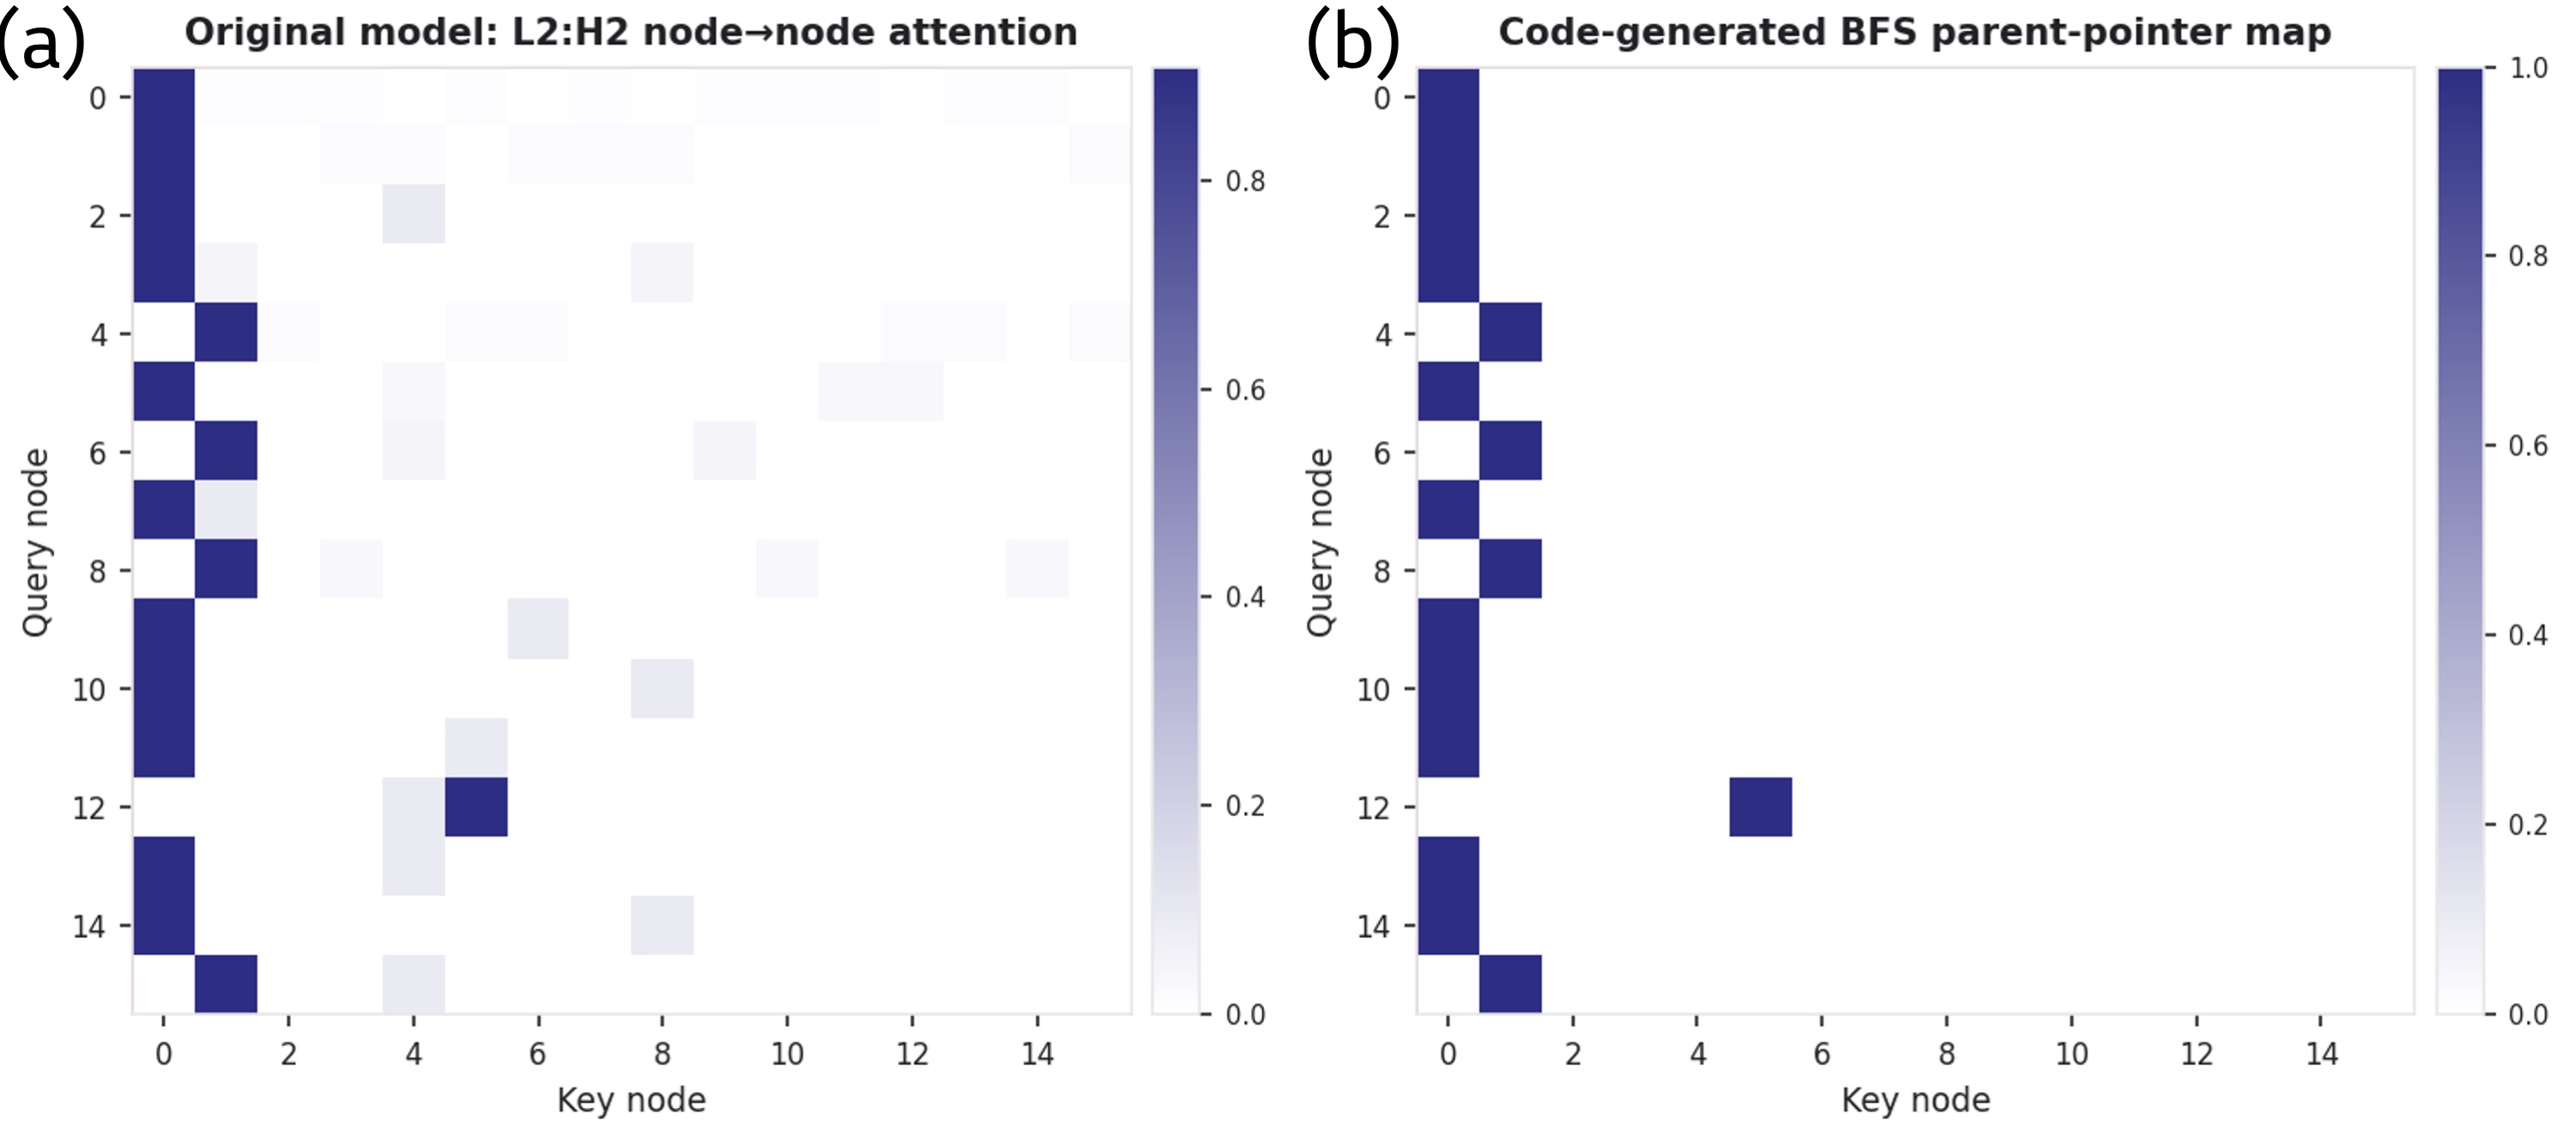
그림 4. (a) L2:H2의 어텐션 맵으로, 모델이 입력 그래프를 루트가 지정된 BFS 트리로 본다는 것을 보여줍니다.
(b) 추론 도중 어텐션 맵을 코드로 생성한 one-hot 어텐션 맵으로 교체해도 모델 성능은 대체로 그대로 유지됩니다.
최단 경로 거리의 경우 모델은 보다 정교한 메커니즘을 사용합니다. 초기 레이어에서는 먼저 차수와 이웃 통계량 등의 국소 구조 특징을 인코딩합니다. 그런 다음 세 번째 레이어의 세 번째 어텐션 헤드는 하나의 인접 노드에 집중하는데, 이 노드는 너비 우선 탐색(BFS)과 유사한 트리에서 부모 노드에 해당하는 경우가 많습니다(즉, 모델은 입력 그래프를 특정 노드를 루트로 하는 BFS 트리로 봅니다. 그림 4 참조). 그 증거로, 이 단일 헤드를 어블레이션(제거)하면 정확도가 크게 떨어지지만, 어텐션 대상을 해당 BFS 부모 노드로 대체하면 성능은 대체로 유지됩니다. 프로브 결과는 또한 이 헤드가 해당 노드로부터 일부 구조 정보를 선택적으로 복사한다는 것을 보여줍니다. 그런 다음 마지막 레이어에서 이렇게 얻은 표현을 정제하며, 어블레이션의 영향은 가까운 노드 쌍보다 거리가 먼 노드 쌍을 예측할 때 훨씬 컸습니다.
실험 전반에서 공통된 계산 패턴이 나타납니다. 모델은 먼저 노드 ID와 간선 끝점 ID의 매칭을 통해 노드와 간선의 연결 관계를 복원하고, 이 정보를 차수와 유사한 국소 특징으로 변환한 다음, 각 태스크에 따라 이러한 특징을 서로 다르게 조합합니다. 이러한 결과는 그래프에 특화된 아키텍처적 편향 없이 트랜스포머가 그래프 연산을 수행하는 방식에 대한 초기 기계론적 설명을 제시합니다.
다음 단계는 보다 현실적인 입력을 처리하는 모델을 이해하는 것입니다. 구체적으로 LG AI연구원의 Materials Intelligence Lab에서는 분자 물성 예측이나 반응 예측과 같은 실제 문제를 해결하기 위해 분자 그래프를 자주 활용합니다. 정확하게 예측하려면 모델은 (1) 분자 그래프를 이해하는 방법과 (2) 화학적 사실과 규칙을 학습해야 할 것으로 예상됩니다. 하지만 실제로 모델이 이 두 가지를 학습하는지는 아직 명시적으로 밝혀내고 확인하지 못했습니다. AI4Science 분야에서도 Mech. interp. 기법의 적용이 현재 활발히 연구되고 있습니다. 이번 행사에서는 Mech. interp.를 그래프를 포함한 다양한 모달리티로 확장해야 한다는 데 연구자들이 공감하고 있음을 확인했습니다.
저희는 앞으로 LG AI연구원이 AI4Science의 해석 가능성, 특히 기계론적 해석 분야에서 핵심적인 역할을 할 것으로 기대합니다. 연구를 계속 진행하면서 Materials Intelligence Lab은 널리 사용되는 화학 모델들을 다시 들여다보고 그 내부 구조를 이해하는 것을 목표로 합니다. 이를 통해 AI 모델과 해당 분야 과학자 간의 정합성에 관한 논의가 활발해지고, Mech. Interp. 분석을 통해 과학적 지식을 얻기 위한 연구도 더욱 확대되기를 기대합니다.
- 참고
[1] Adebayo et al., “Sanity Checks for Saliency Maps”, NeurIPS 2018
[2] “Thread: Circuits” (2020/03/10). Distill. https://distill.pub/2020/circuits/
[3] Elhage et al. (2021/12/22) “A Mathematical Framework for Transformer Circuits”, Transformer circuits thread. https://transformer-circuits.pub/2021/framework/index.html
[4] Olsson et al. (2022/03/08) “In-context Learning and Induction Heads”, Transformer circuits thread. https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html
[5] Nanda et al., “Progress measures for grokking via mechanistic interpretability”, ICLR 2023
[6] Cunningham et al., “Sparse autoencoders find highly interpretable features in language models”, arXiv 2309.08600
[7] Conmy et al., “Towards automated circuit discovery for mechanistic interpretability”, NeurIPS 2023
[8] Heimersheim & Nanda, “How to use and interpret activation patching”, arXiv 2404.15255.
[9] Lieberum et al., “Gemma Scope: Open Sparse Autoencoders Everywhere All At Once on Gemma 2”, arXiv 2408.05147.
[10] Shin et al., “Discovering Mechanisms in Tokenized Graph Transformers”, ICML Workshop on Mechanistic Interpretability, 2026
[11] Schut et al., “Bridging the human?AI knowledge gap through concept discovery and transfer in AlphaZero”. PNAS, 122 (13) e2406675122, https://doi.org/10.1073/pnas.2406675122 (2025).
[12] Kim et al., “Pure Transformers are Powerful Graph Learners”, NeurIPS 2022