 Deunsol Yoon
2026.10.26
[ICML2026] LLM을 활용한 강화학습의 관측과 행동 설계
강화학습은 Agent가 Environment와 상호작용하며 더 나은 의사결정을 학습하는 AI 기술입니다. Robot Control뿐 아니라 공장 운영, 물류, 생산 계획처럼 연속적인 판단이 필요한 문제에도 활용할 수 있습니다. 이때 성능을 좌우하는 요소는 RL Algorithm과 Reward Function만이 아닙니다. Agent가 어떤 정보를 입력 받을지를 결정하는 Observation Space와 어떤 범위와 단위로 의사결정을 내릴지를 결정하는 Action Space 역시 중요한 요소로, 각각 Agent의 ‘눈과 손’에 해당합니다. Observation과 Action이 Task의 특성에 맞게 설계되지 않으면 Agent가 효과적인 Policy를 학습하기까지 더 많은 시간과 데이터가 필요할 수 있습니다.
올해 7월 서울에서 열린 제43회 International Conference on Machine Learning(ICML 2026)은 Machine Learning의 기초 연구부터 Robotics·생명과학·Data Science의 응용 연구까지 폭넓게 다루는 대표적인 국제 학회입니다. LG AI연구원은 이번 학회에서 LLM이 Observation·Action Space를 직접 설계하는 “Designing Observation and Action Models for Efficient Reinforcement Learning with LLMs”[1] 연구를 발표했습니다. 산업 현장에서 시작된 질문을 글로벌 연구 커뮤니티와 공유하고 다양한 연구자들과 Environment Design 자동화의 가능성을 논의한 의미 있는 자리였습니다.
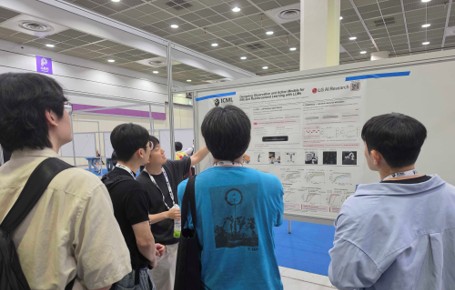
이미지 1. ICML 2026 Poster Session에서 LOAM의 핵심 아이디어와 실험 결과를 소개하고, 참석 연구자들과 의견을 나누는 모습
1. 산업 현장에서 시작된 질문: AI는 무엇을 보고 판단해야 할까?
1.1 NCC 프로젝트에서 시작된 질문
이 연구의 출발점은 2022년부터 참여해 온 ‘NCC 운영 최적화 AI 스케줄러 개발 프로젝트’[2,3,4] 였습니다. 이 프로젝트는 LG AI연구원과 LG화학이 함께 추진한 과제로, 실제 LG화학 대산 NCC 공장의 복잡한 생산 Scheduling을 최적화해 수익성을 높이는 강화학습 기반 AI Scheduler 개발을 목표로 했습니다. NCC(Naphtha Cracking Center)는 납사를 열분해해 에틸렌과 프로필렌 같은 기초 석유화학 원료를 생산하는 복잡한 공정입니다. 당시 저희 팀은 NCC에 대한 사전 지식이 거의 없는 상태에서 강화학습 기반 생산 계획 최적화 프로젝트를 시작했습니다. 공장이 어떻게 돌아가는지, 현장 전문가가 어떤 정보를 보고 판단하는지, 정상 예외 상황에서 어떤 제약을 적용하는지를 이해하기 위해 현업 담당자들과 수많은 인터뷰를 진행했습니다. 돌이켜보면 강화학습 알고리즘을 구현하고 학습시키는 시간보다 현장을 이해하고, 전문가의 판단을 Observation·Action·Reward 구조로 옮기는 데 더 많은 시간을 들였습니다.
1.2 보상보다 어려웠던 관측과 행동 설계
이 경험을 통해 현실에 강화학습을 적용하려면 Reward Function뿐 아니라 Observation Space와 Action Space도 세심하게 설계해야 한다는 점을 체감했습니다. NCC 프로젝트에서는 최적화하려는 목표와 평가 지표가 비교적 명확했기 때문에 Reward Function을 정의하는 과정은 상대적으로 직관적이었습니다. 반면 수많은 운영 변수 가운데 어떤 정보를 Policy의 입력으로 제공할지, Policy가 어느 범위와 단위로 의사결정을 내리도록 Action Space를 구성할지는 쉽게 답하기 어려웠습니다. 이러한 설계에는 현장 전문가의 경험과 문서로 표현하기 어려운 암묵적인 운영 지식이 필요했습니다. 새로운 산업 Task가 주어질 때마다 강화학습 전문가와 현장 전문가가 이 과정을 처음부터 반복해야 하는가라는 질문도 남았습니다.
이후 EUREKA[5], Text2Reward[6]처럼 LLM을 활용해 Reward Function을 설계하는 연구가 등장하면서, LLM의 Semantic Reasoning 능력으로 강화학습 Environment의 다른 구성 요소도 설계할 수 있겠다는 가능성을 확인했습니다. Reward Design에 비해 Observation·Action Space Design은 상대적으로 연구가 부족했고, NCC 프로젝트에서 실제로 더 큰 어려움을 겪은 영역이기도 했습니다. 이러한 문제의식은 LLM을 활용해 Observation Model과 Action Model을 설계하는 LOAM 연구로 이어졌습니다.
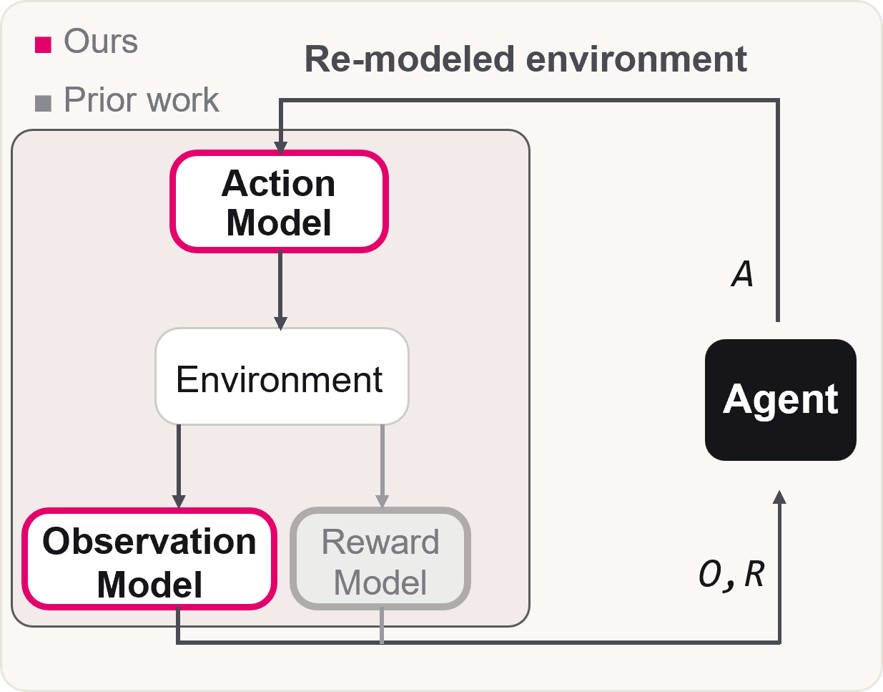
이미지 2. 관측·행동 모델을 통한 강화학습 환경 재설계
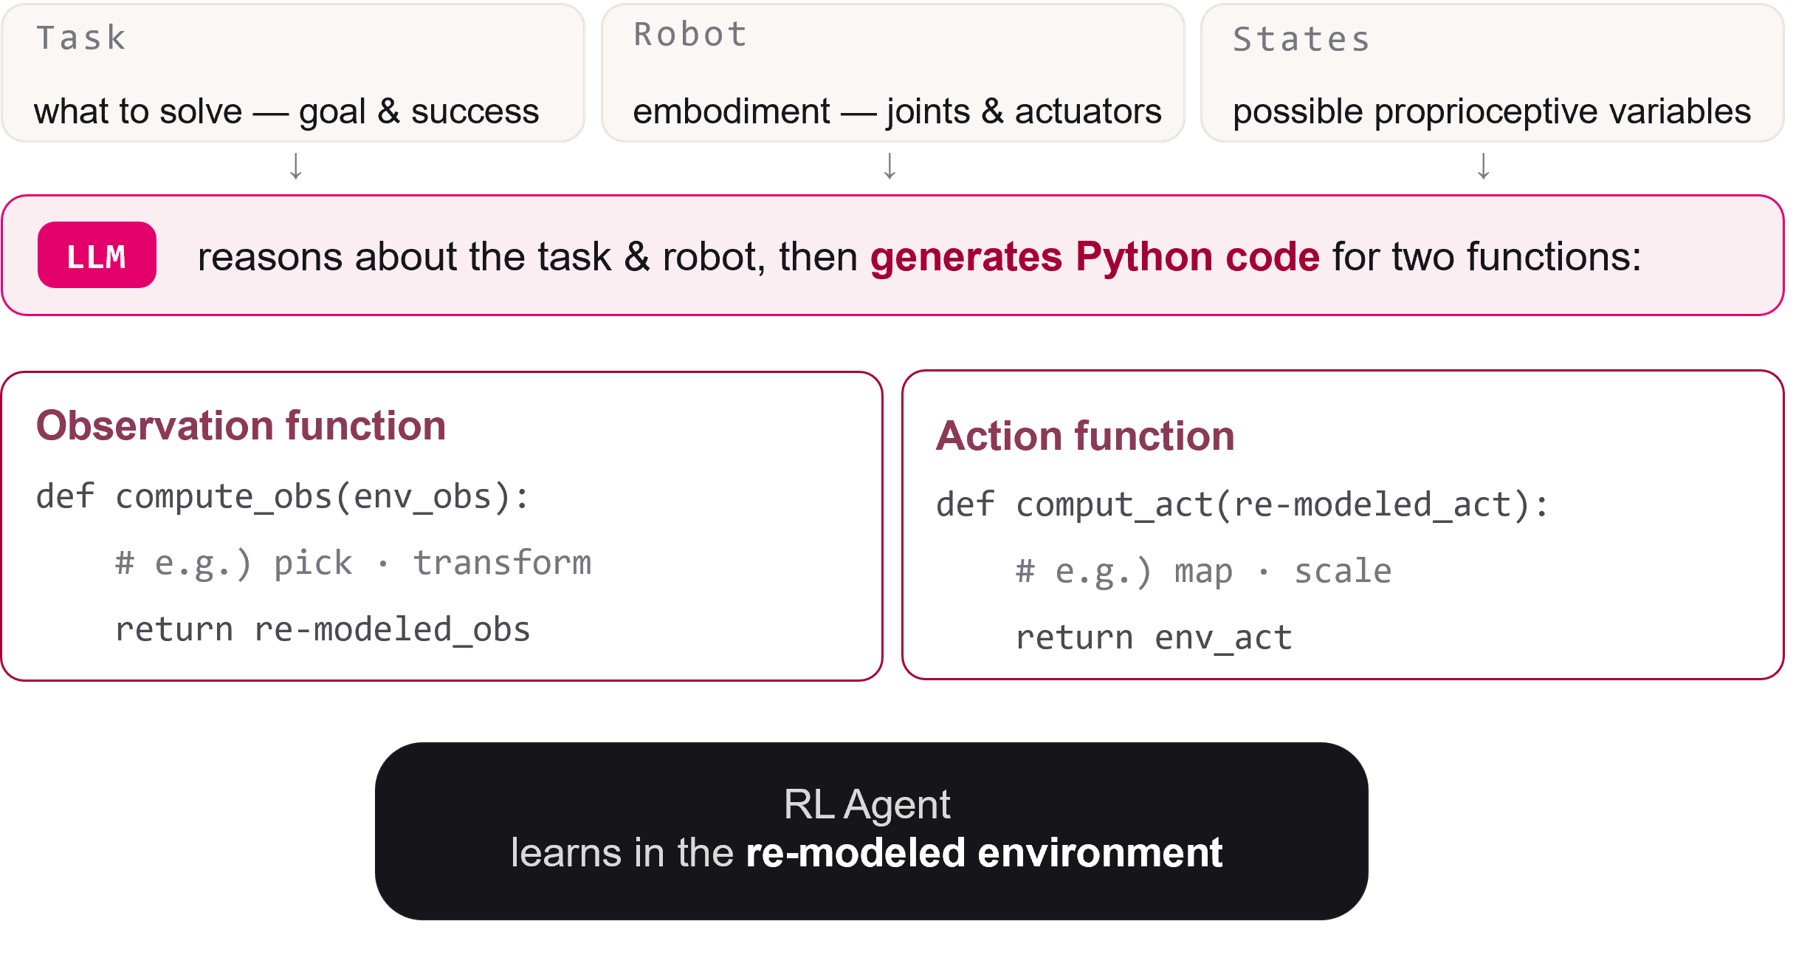
이미지 3. 과제·로봇·상태 설명에서 관측 함수와 행동 함수를 생성하는 LOAM
아래는 HumanoidBench의 Run Task에서 LLM이 생성한 Observation Model을 축약한 예시입니다.
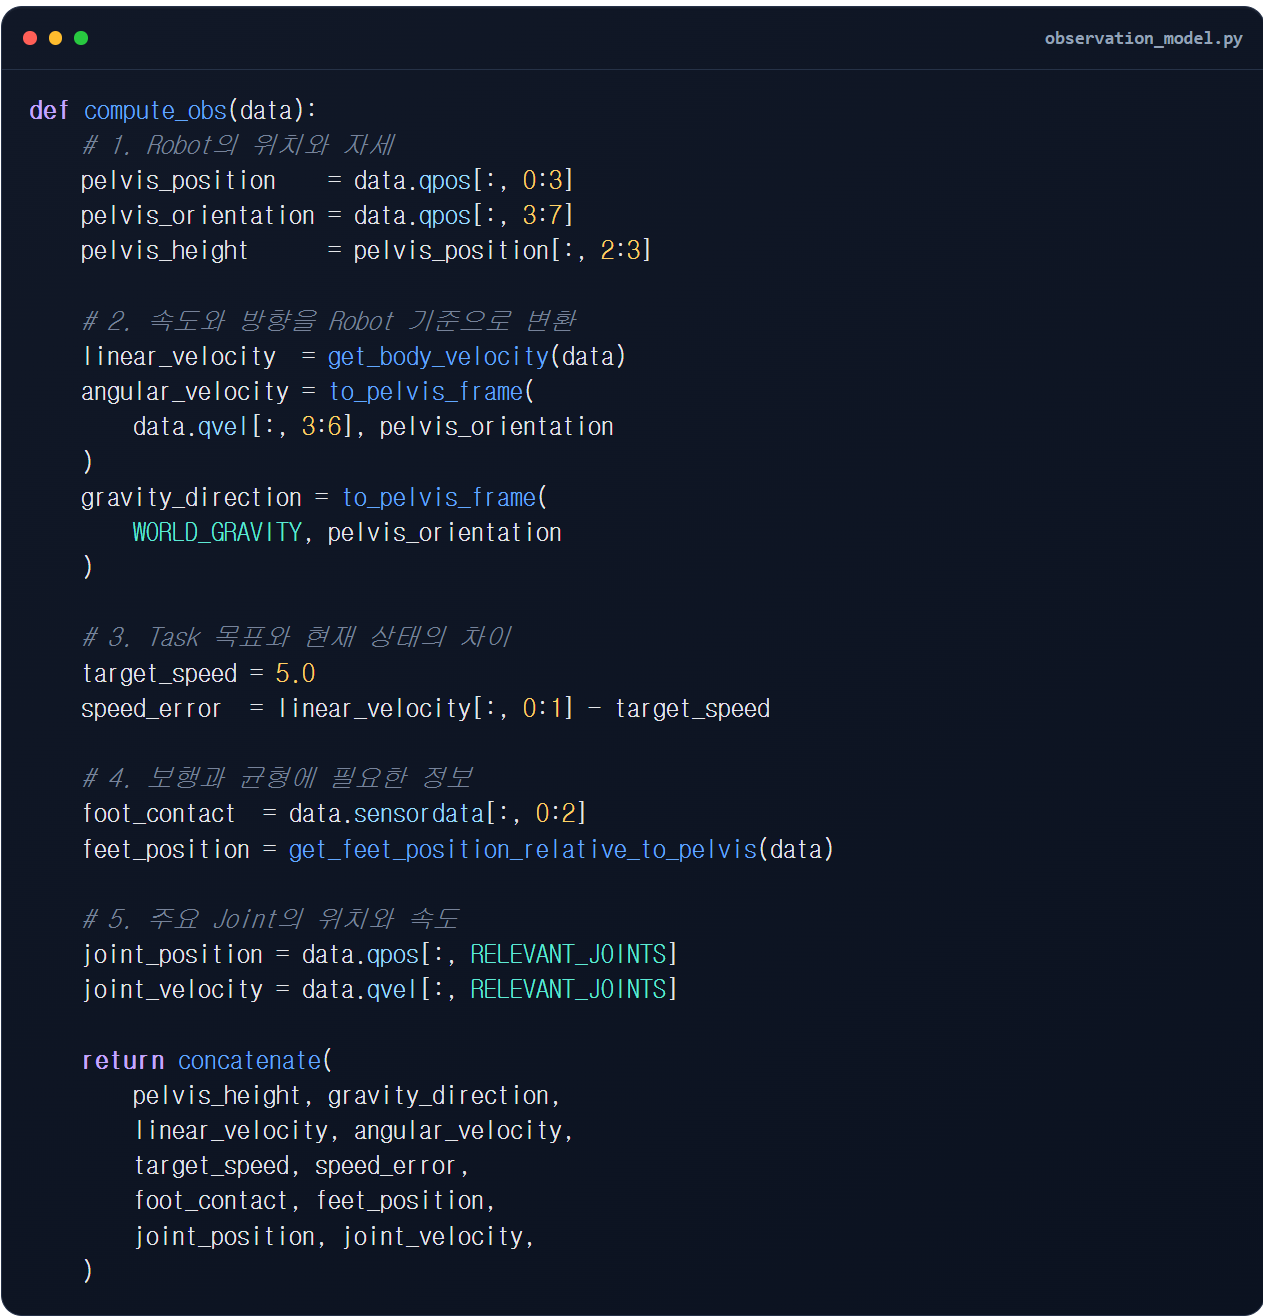
이미지 4. LLM이 생성한 HumanoidBench 달리기 Task의 Observation Model 축약 예시
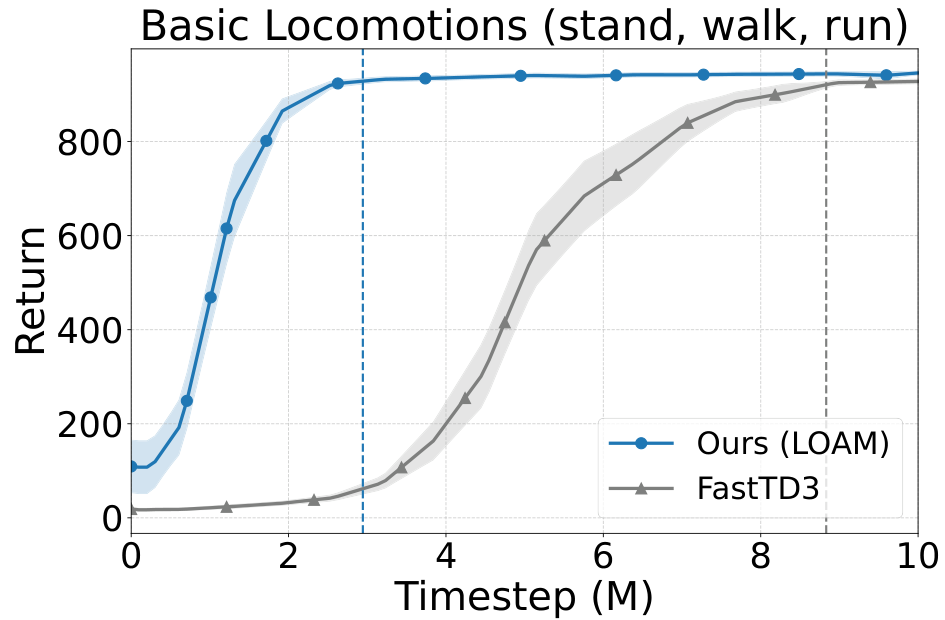
이미지 5. HumanoidBench의 stand·walk·run Task 학습 결과
Prompt 역시 새로운 Task와 Domain에 쉽게 적용할 수 있도록 Modular하게 구성했습니다. 환경이 바뀌면 Task의 목표와 Robot의 구조, 사용할 수 있는 Observation과 Action에 대한 설명만 새롭게 제공하고 나머지 Prompt는 동일하게 활용할 수 있습니다. 이러한 정보는 대부분 Environment Documentation이나 API에서 얻을 수 있습니다. 따라서 강화학습 전문가와 현장 전문가가 과제마다 Observation·Action Space를 처음부터 수작업으로 설계하는 대신, 기존에 제공된 정보를 정리하는 것만으로도 LLM이 초기 설계안을 생성할 수 있습니다.
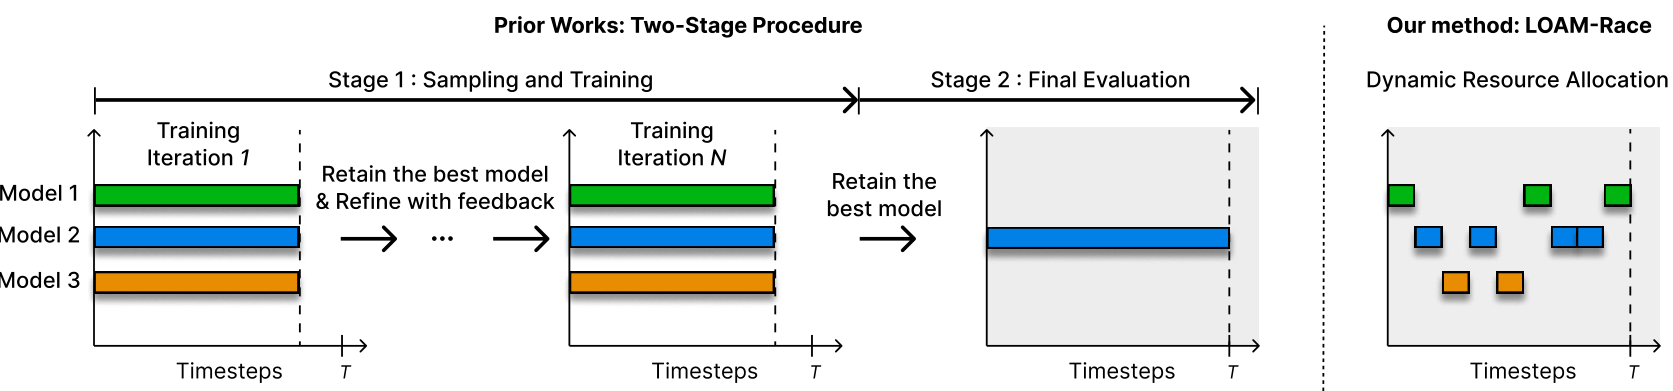
이미지 6. 후보의 잠재력을 예측해 학습 자원을 동적으로 배분하는 LOAM-Race
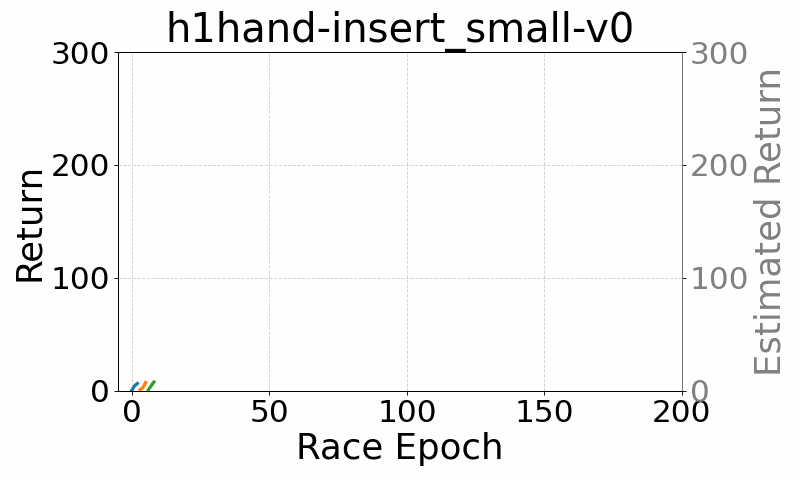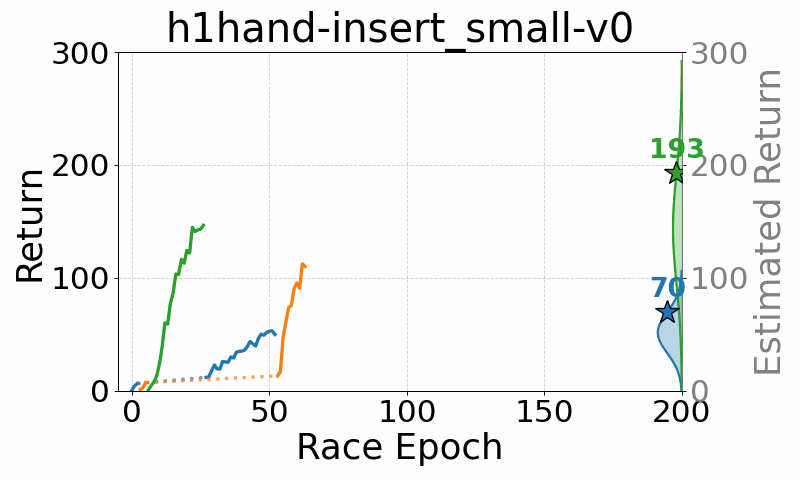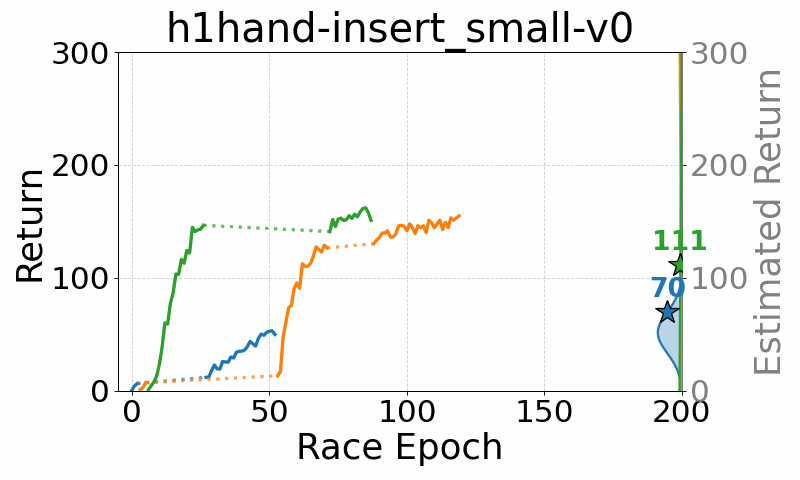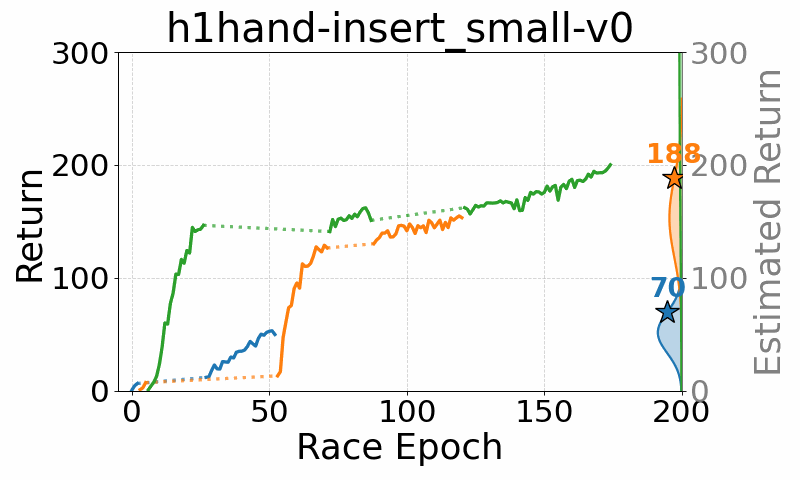
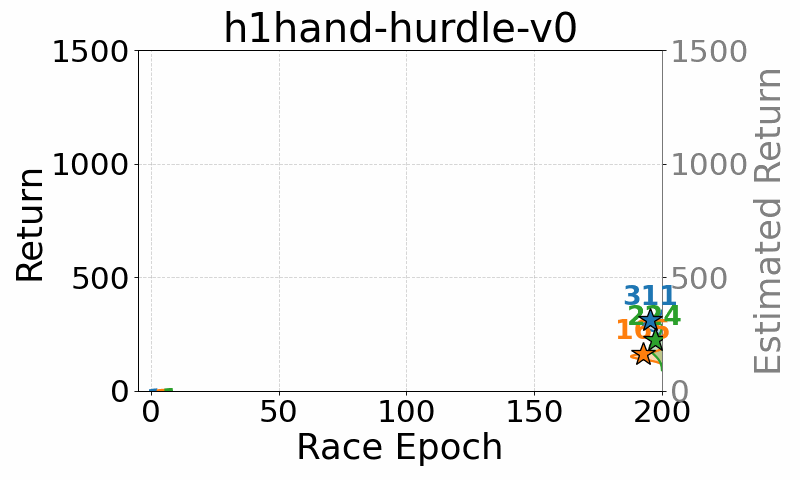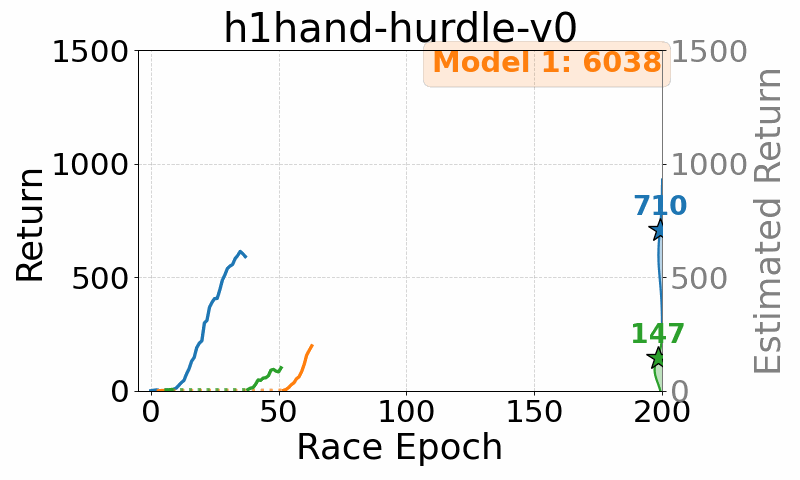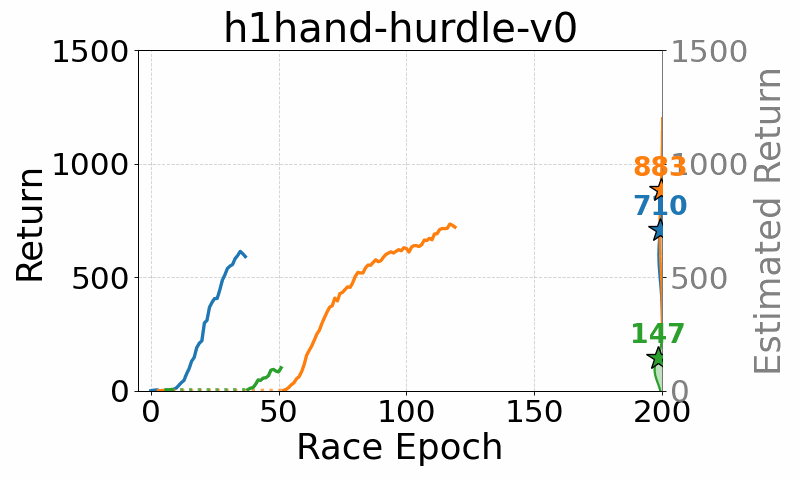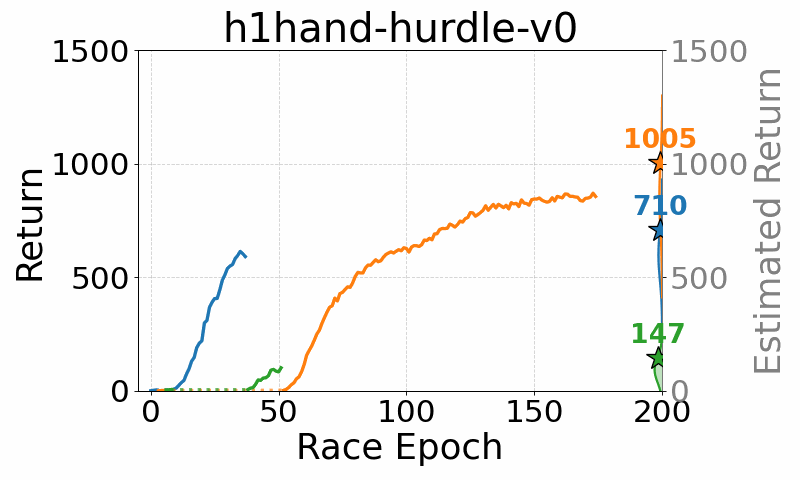
이미지 7. 여러 관측·행동 설계 후보가 학습 과정에서 경쟁하는 LOAM-Race
LOAM-Race의 Racing 방식은 Observation·Action Model을 선택하는 문제에만 국한되지 않습니다. 여러 Candidate를 평가해야 하지만 각각을 끝까지 학습하는 데 드는 비용이 큰 경우에는, 초기 Learning Curve에서 최종 성능과 불확실성을 예측하고 유망한 Candidate에 Training Budget을 집중하는 방식을 활용할 수 있습니다. 예를 들어 Hyperparameter Search나 기계학습 Algorithm·Model Architecture 비교처럼 많은 설정을 반복적으로 학습해야 하는 과정에 적용하면, 가능성이 낮은 Candidate에 사용되는 자원을 줄이면서도 잠재력이 높은 Candidate를 효율적으로 탐색할 수 있습니다. 이러한 관점에서 LOAM-Race는 다양한 AI 실험의 탐색 비용을 줄일 수 있는 범용적인 Resource Allocation 방법으로 확장될 가능성이 있습니다.
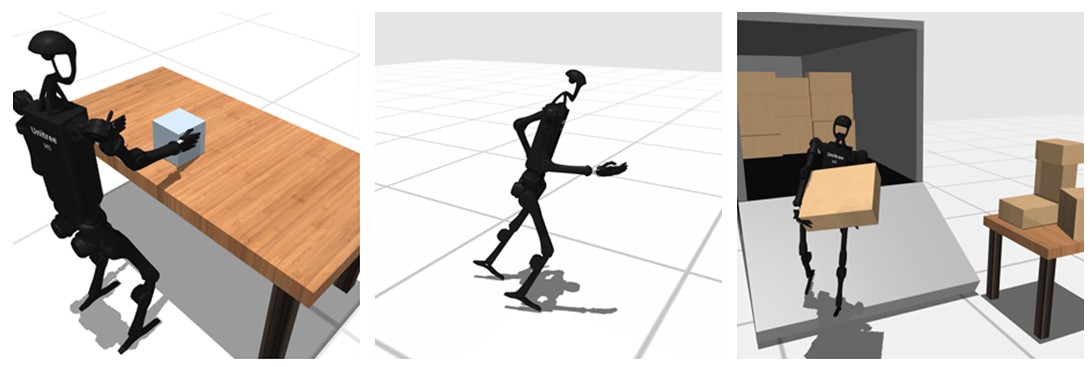
이미지 8. HumanoidBench
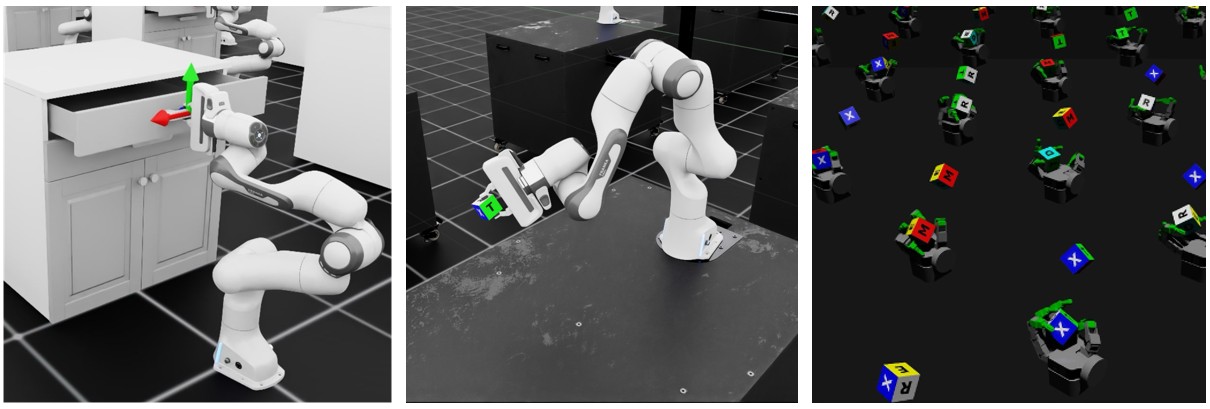
이미지 9. Isaac Lab
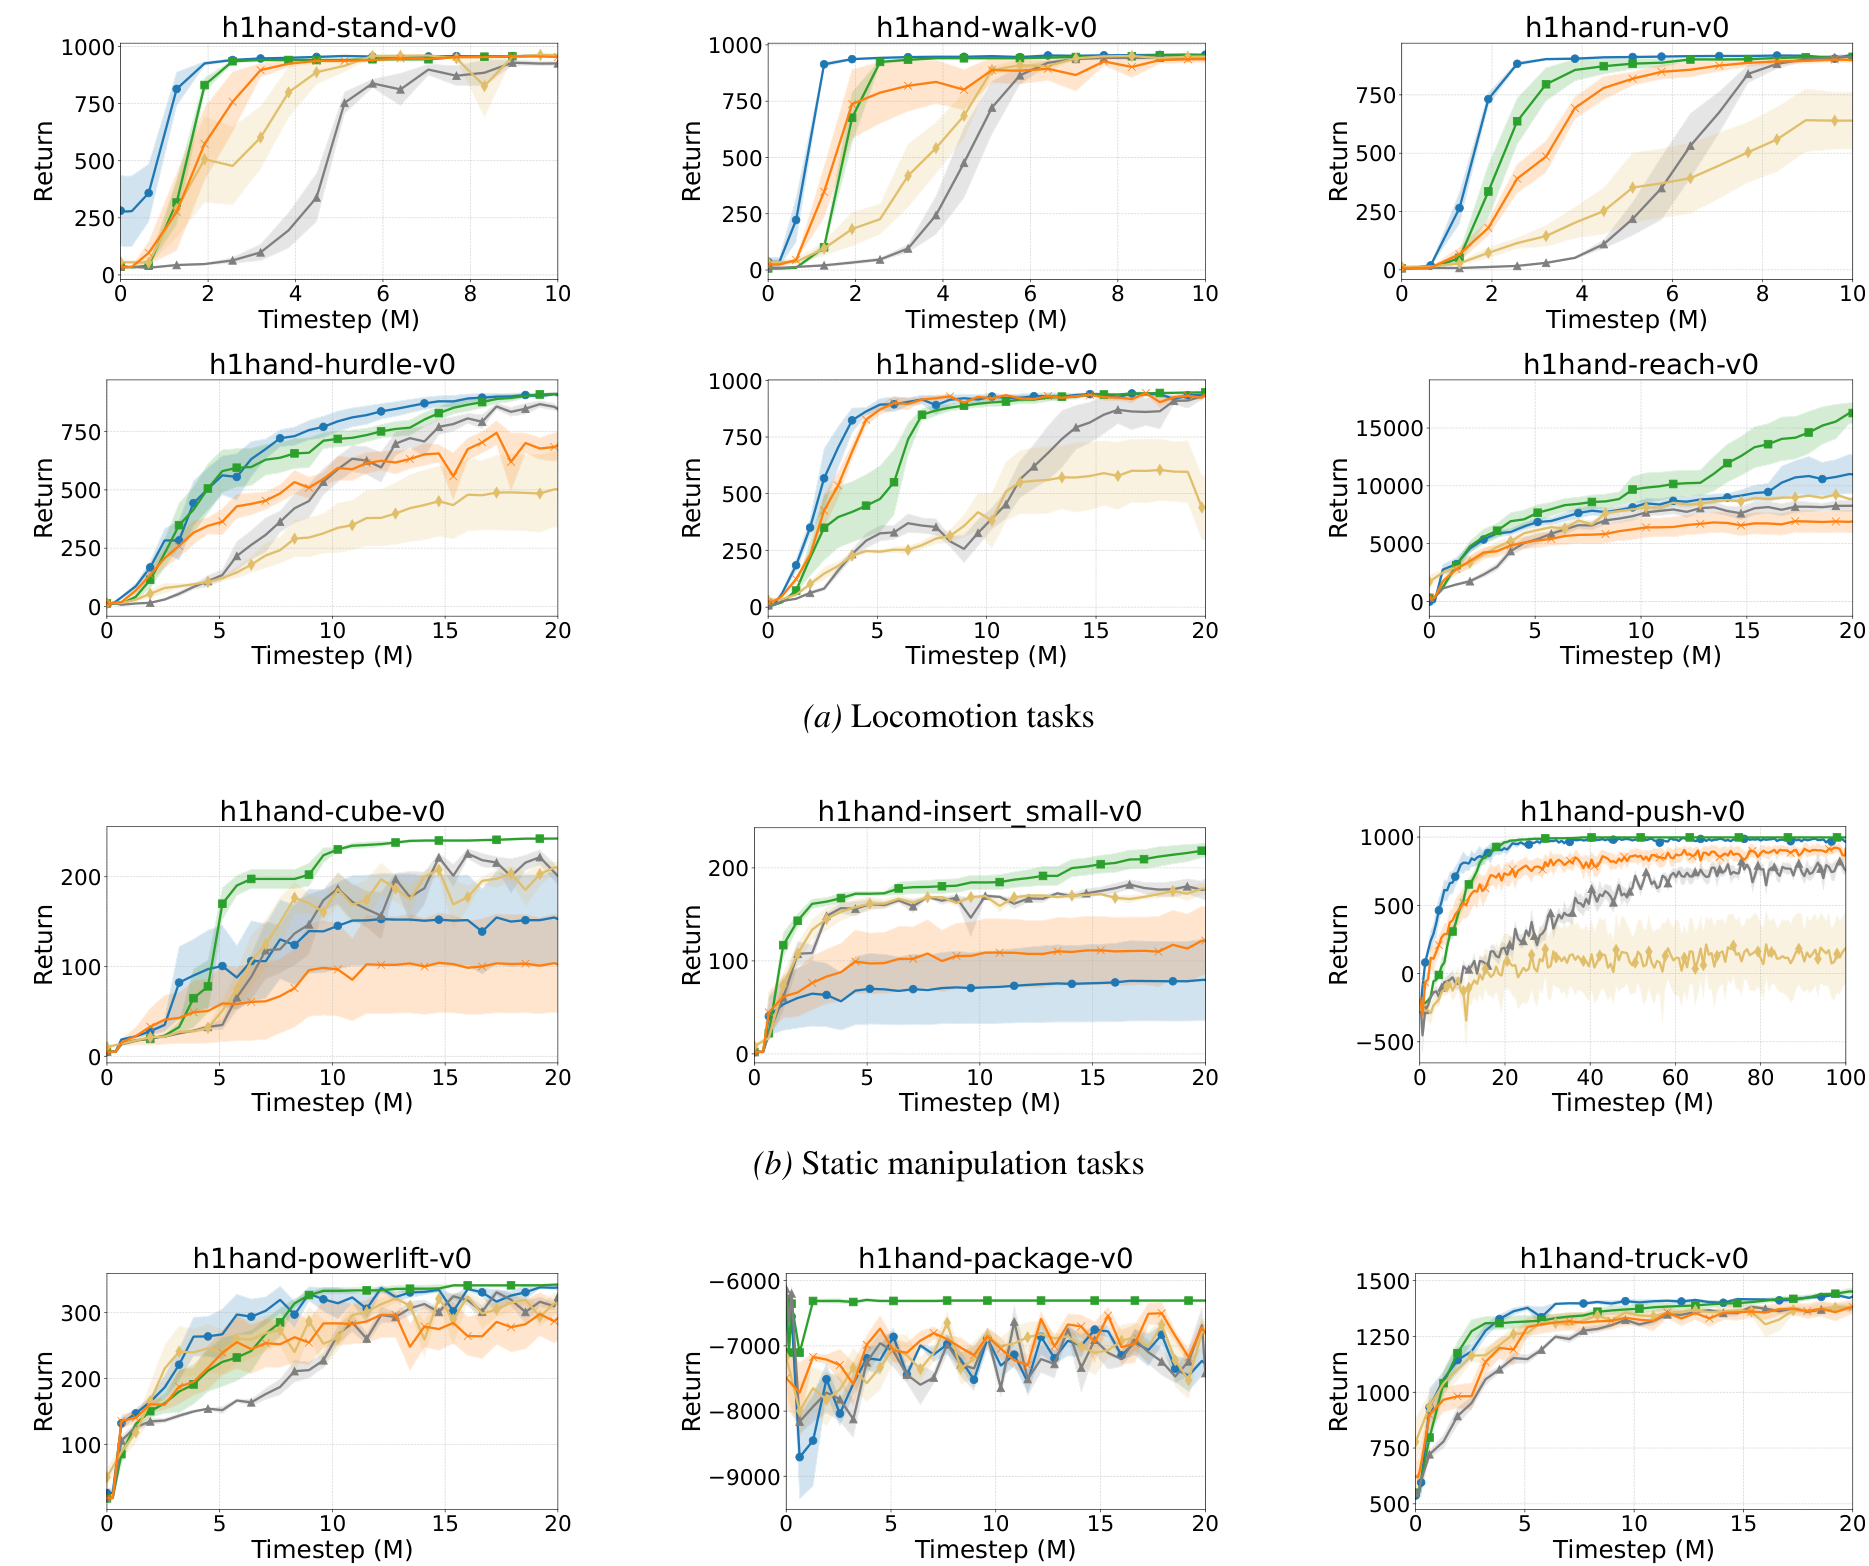
이미지 10. HumanoidBench 실험 결과
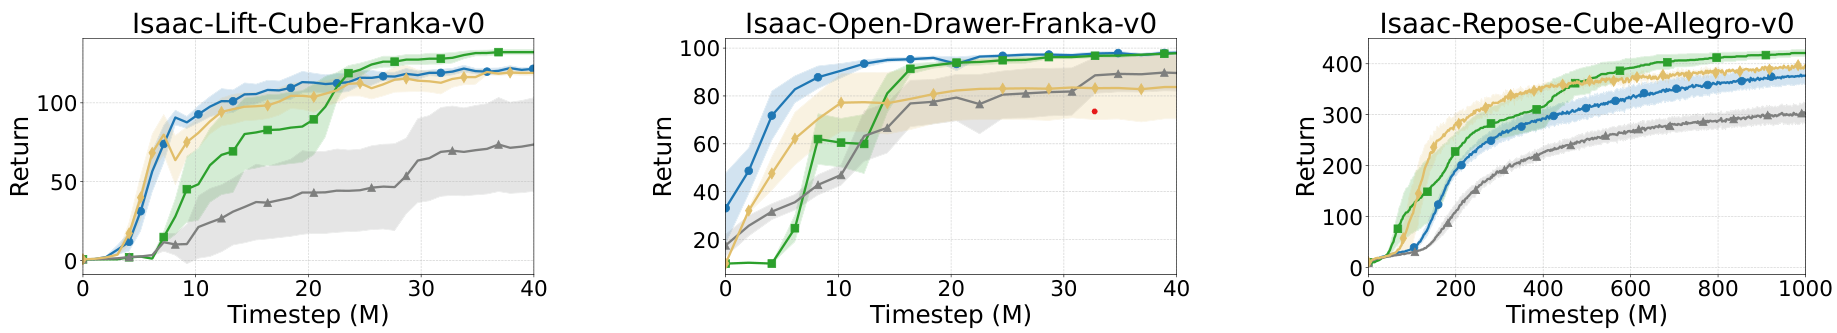
이미지 11. Isaac Lab 실험 결과.
이 밖에도 논문에는 Observation Model과 Action Model의 개별 효과, LOAM-Race의 Candidate Selection 방식과 Candidate 수에 따른 차이, 다양한 LLM Backbone에서의 성능 등 추가 실험과 분석이 포함되어 있습니다. LOAM과 LOAM-Race의 구체적인 동작 및 결과가 궁금하다면 논문을 참고해 주세요.
- 참고
[1] Yoon et al., Designing Observation and Action Models for Efficient Reinforcement Learning with LLMs, ICML 2026.
[2] LG AI Research, “2025 LG Awards 고객만족상 수상! AI가 산업 혁신의 주인공이 되기까지,” LG AI Research News, 2025.06.04. https://www.lgresearch.ai/news/view?seq=567.
[3] Yoon, D., “[AAMAS 2024] Multi-Agent Reinforcement Learning for Real-World Application (1편),” LG AI Research Blog, 2024.06.26. https://www.lgresearch.ai/blog/view?seq=443
[4] Hong et al., “Naphtha Cracking Center Scheduling Optimization using Multi-Agent Reinforcement Learning: Demonstration Track,” Proceedings of the 23rd International Conference on Autonomous Agents and Multiagent Systems (AAMAS 2024), pp. 2806-2808, 2024.
[5] Ma et al., Eureka, Human-level reward design via coding large language models. ICLR 2024.
[6] Xie et al., Text2Reward: Reward shaping with language models for reinforcement learning. ICLR 2024.
[7] Sferrazza et al., HumanoidBench: Simulated humanoid benchmark for whole-body locomotion and manipulation., RSS 2024.
[8] Seo et al., FastTD3: Simple, fast, and capable reinforcement learning for humanoid control., arXiv preprint 2025.
[9] Wang et al., “LLM-Empowered State Representation for Reinforcement Learning,” ICML 2024.