 Seunghan Lee
2026.11.03
[ICML2026] 정형 데이터를 위한 파운데이션 모델, 그리고 시계열 딥러닝의 현재
들어가며
이미지와 언어를 중심으로 발전해 온 딥러닝은 눈부신 성과를 거뒀지만, 산업 현장에서 매일 쌓이는 데이터의 상당수는 여전히 Tabular 데이터와 시계열(Time Series) 데이터의 형태입니다. 공정 설비의 센서 로그, 반도체 수율 데이터, 금융 거래 내역, 병원의 전자의무기록은 모두 행과 열 또는 시간 축을 따라 정렬된 숫자의 나열입니다. 이러한 정형 데이터(Structured Data)는 산업 현장에서 가장 흔하게 접하는 데이터 유형이지만, 역설적으로 딥러닝이 가장 늦게 도달한 영역이기도 합니다. 지난 10여 년간 XGBoost와 LightGBM 같은 트리 기반 모델이 사실상의 표준으로 자리해 온 것이 이를 보여줍니다.
그러나 최근 2~3년 사이 이러한 흐름이 빠르게 바뀌고 있습니다. 대규모 합성 데이터로 사전학습한 뒤 별도의 학습 없이 한 번의 추론만으로 예측을 수행하는 파운데이션 모델(Foundation Model)이 정형 데이터 영역에도 본격적으로 등장했기 때문입니다. Tabular 데이터에서는 TabPFN이 Nature에 게재되며 기존 트리 모델을 앞서는 성능을 보였고[1], 시계열에서도 제로샷 예측이 가능한 파운데이션 모델들이 잇따라 등장했습니다. "데이터셋마다 모델을 새로 학습시킨다"는 오랜 전제가 흔들리기 시작한 것입니다.
이러한 변화는 머신러닝 분야 최고 권위의 학회인 ICML(International Conference on Machine Learning) 2026에서도 뚜렷하게 나타났습니다. LG AI연구원은 2026년 7월 6일부터 11일까지 서울 코엑스에서 열린 ICML 2026에 참가해 연구 성과를 발표하고, 정형 데이터와 시계열 분야의 최신 동향을 확인했습니다. 이 글에서는 LG AI연구원이 발표한 연구와 함께 이번 학회에서 주목할 만한 시계열 딥러닝 연구들을 정리합니다.
ICML 2026, 서울에서 열리다
올해로 43회를 맞은 ICML 2026은 국내에서 처음 개최된 ICML로, 서울 코엑스에서 열렸습니다. 23,918편의 논문이 제출됐고, 그중 6,352편이 채택됐습니다(채택률 26.6%). 제출 편수는 전년 대비 두 배 가까이 늘어났습니다[2].
올해 수상 결과의 중심에는 확산 모델(Diffusion Model)이 있었습니다. Outstanding Paper Award 두 편은 확산 언어 모델에서 임의 순서 생성이 갖는 가치를 재검토한 「The Flexibility Trap」과 확산 모델의 고정밀 샘플링을 다룬 「High-Accuracy Sampling for Diffusion Models and Log-Concave Distributions」에 돌아갔습니다. Test of Time Award는 2016년 심층 강화학습의 이정표가 된 A3C 논문(Asynchronous Methods for Deep Reinforcement Learning)이 수상했습니다[3]. 생성 모델이 주목받는 가운데, 정형 데이터를 다루는 연구들도 조용하지만 꾸준히 영역을 넓혀 가고 있습니다. 시계열을 다룬 논문들이 본회의에서 다수 발표되었고, 정형 데이터 파운데이션 모델을 주제로 한 워크숍도 올해 2회째를 맞았습니다.
LG AI연구원의 연구: Tabular 파운데이션 모델은 왜 소수 클래스를 놓치는가
문제 제기: TabPFN의 다수 클래스 편향
이번 ICML 2026에서 LG AI연구원이 발표한 연구는 「Mitigating Label Shift in Tabular In-Context Learning via Test-Time Posterior Adjustment」 입니다[4]. Tabular 파운데이션 모델이 클래스 불균형 상황에서 성능이 저하되는 현상을 짚고, 추론 시점의 간단한 보정만으로 이를 완화하는 방법을 제안한 연구입니다.
TabPFN은 Tabular 데이터를 위한 파운데이션 모델입니다. 방대한 합성 데이터로 사전학습을 마친 뒤, 실제 문제를 풀 때는 학습 데이터 전체를 문맥(Context)으로 입력받아 단 한 번의 순전파(Forward Pass)만으로 예측을 수행합니다. 이른바 인컨텍스트 러닝(In-Context Learning, ICL) 방식으로, 파라미터 업데이트가 전혀 없다는 점에서 기존 모델과 기존 모델과 차이가 있습니다. 소규모 데이터셋에서 XGBoost를 능가하는 성능을 보이며 큰 주목을 받았습니다.
그런데 저희는 이 모델에서 그동안 간과되어 온 취약점 하나를 발견했습니다. 바로 레이블 분포 변화(Label Shift)입니다. 이는 학습 데이터와 테스트 데이터에서 클래스별 특성 분포 P(X|Y)는 같지만 클래스 비율 P(Y)가 달라지는 상황을 뜻합니다. 실제 산업 데이터에서는 이러한 상황이 오히려 일반적입니다. 불량품 검출, 이상 탐지, 질병 진단처럼 정작 찾아내야 하는 대상이 소수 클래스인 경우가 많기 때문입니다.
실제로 저희가 OpenML의 253개 Tabular 데이터셋을 분석한 결과, 약 85%(214개)가 클래스 불균형 상태였습니다. 그리고 TabPFN은 문맥으로 주어진 클래스 불균형을 예측에 그대로 반영합니다. 극단적인 사례에서는 전체 테스트 샘플의 98.3%를 다수 클래스로 예측해, 소수 클래스에 대한 재현율이 사실상 무너지는 현상을 관찰했습니다. 학습과 테스트가 같은 데이터셋에서 이루어졌음에도 이러한 결과가 나타났다는 점에서 문제의 심각성을 확인할 수 있습니다.
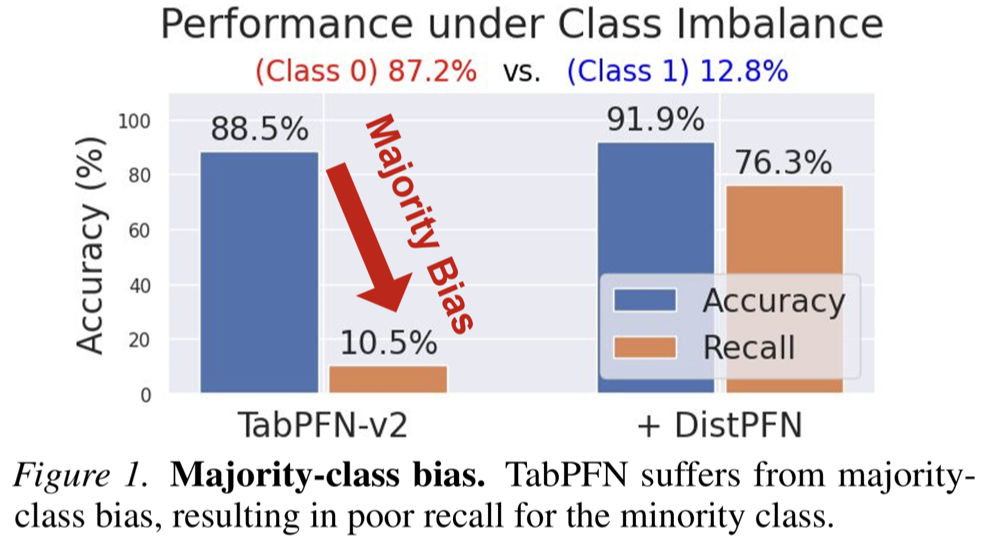
이미지 1. TabPFN은 다수 클래스로 예측이 쏠려 소수 클래스의 재현율이 크게 떨어진다. (출처: Lee [4], Figure 1)
┌── 보정 계수 ──┐
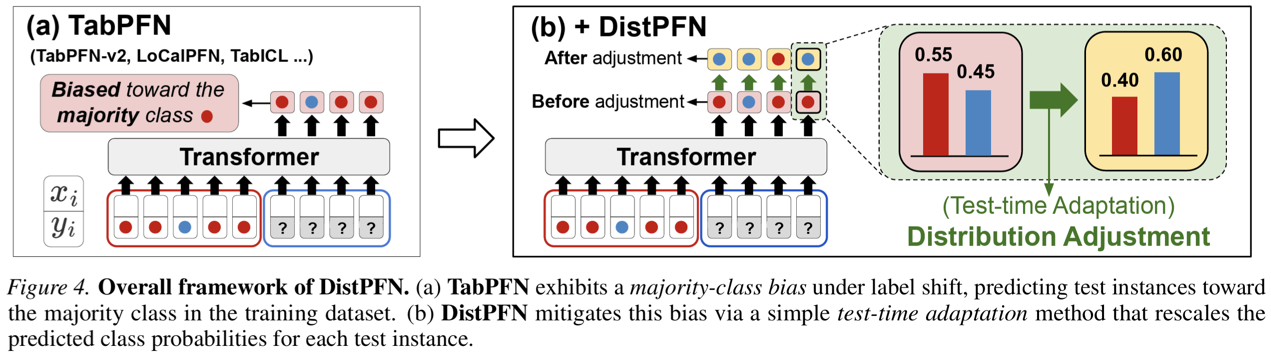
이미지 2. DistPFN의 전체 구조. 다수 클래스로 쏠린 TabPFN의 예측(좌)을 추론 시점의 분포 보정만으로 완화한다(우). (출처: Lee [4], Figure 4)
● 세 종류의 Tabular 파운데이션 모델(TabPFN-v2, TabICL, LoCalPFN) 모두에서 일관된 성능 향상을 확인했습니다. 예를 들어 시프트가 강한 조건(β=5)에서 TabICL의 정확도를 DistPFN은 12.3%, DistPFN-T는 13.7% 끌어올렸습니다(상대 개선율 기준).
● 시프트가 없는 일반적인 상황에서는 본래의 성능을 그대로 유지합니다. 반면 기존 보정 기법인 EME와 BBE는 시프트가 없을 때 오히려 최대 1.7%p의 성능 하락을 보였습니다. 즉, 시프트가 있을 때는 효과를 내면서도, 시프트가 없는 경우에는 성능 저하가 발생하지 않는 보정 방식인 셈입니다.
● 추가 연산 비용이 사실상 없습니다. TabPFN-v2 기준 평균 예측 시간이 1.002초에서 1.003초로 늘어났을 뿐입니다.
● 테스트 레이블의 실제 분포를 알고 있다고 가정한 오라클(Oracle) 성능에 근접했습니다. 여섯 단계의 시프트 강도에 걸친 평균 정확도 기준으로 오라클이 0.796, DistPFN-T가 0.792입니다.
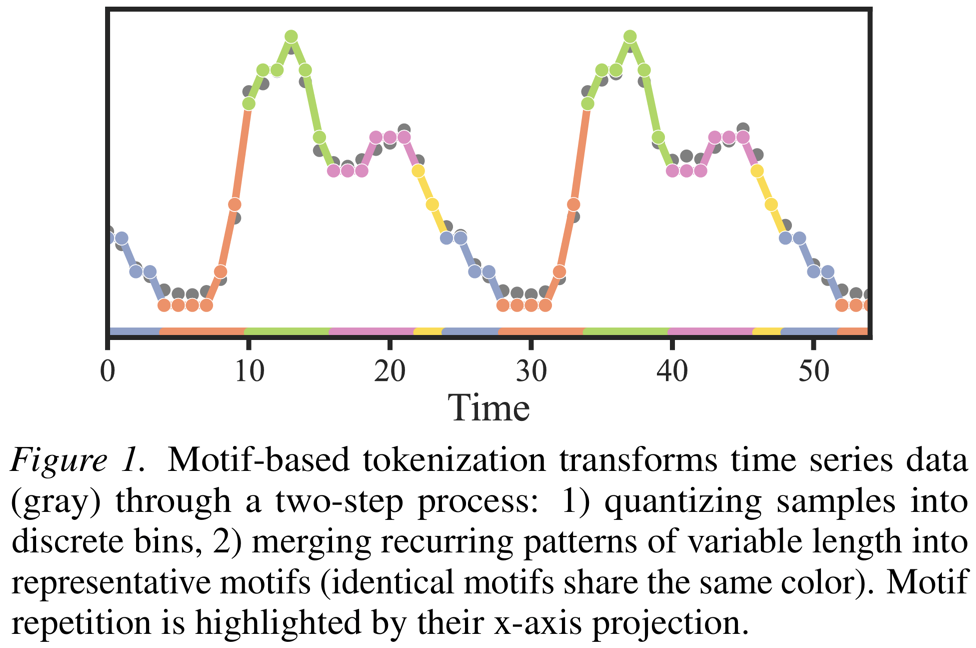 이미지 3. 시계열을 이산 심볼로 양자화한 뒤, 반복되는 가변 길이 패턴을 하나의 모티프 토큰으로 병합한다. (출처: Gotz et al. [5], Figure 1)
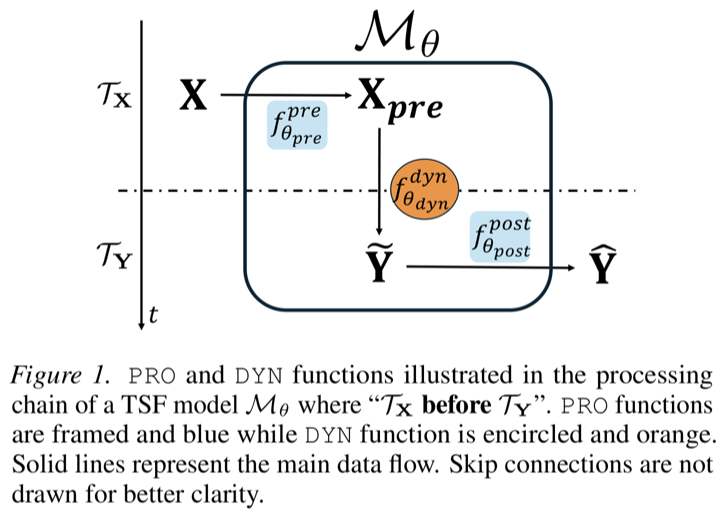
이미지 4. 시계열 예측 모델을 일반 처리(PRO) 함수와 동역학(DYN) 함수의 합성으로 분해하는 PRO-DYN 체계. (출처: Brachet et al. [6], Figure 1)
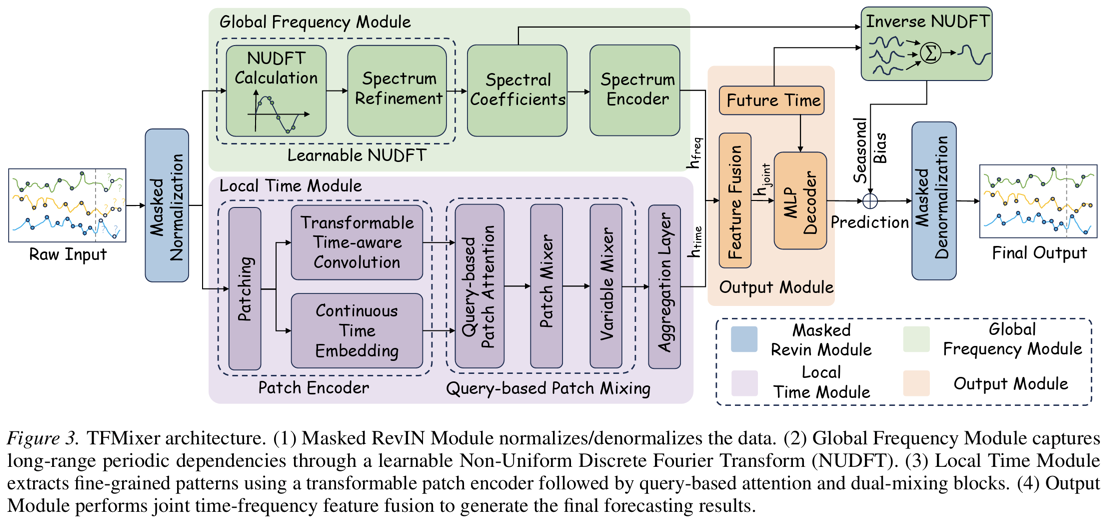
이미지 5. TFMixer의 구조. 학습 가능한 비등간격 푸리에 변환(NUDFT)으로 전역 주기성을, 쿼리 기반 패치 결합으로 지역 패턴을 포착한다. (출처: Qiu et al. [8], Figure 3)
● Causal Foundation Models for Time Series based on Prior-Data Fitted Networks[10] - TabPFN의 근간이 되는 PFN(Prior-Data Fitted Network, 합성 데이터로 미리 학습해 두고 추론 시점에는 주어진 문맥만으로 예측하는 구조)을 시계열의 인과 추론으로 확장한 연구입니다. LG AI연구원이 다룬 Tabular 데이터 ICL과 시계열 예측이 결국 같은 뿌리에서 출발했음을 보여주는 사례입니다.
● TiViT: Time Series Representations for Classification Lie Hidden in Pretrained Vision Transformers[11] - 사전학습된 비전 트랜스포머 내부에 이미 시계열 분류에 유용한 표현이 잠재해 있다는 관점에서, 모달리티 간 전이 가능성을 다시 짚어 본 연구입니다.
● Do Tabular Foundation Models Learn Rules or Memorize Exemplars?[12] / Tabular Foundation Models Are Effectively Shallow[13] - Tabular 파운데이션 모델이 실제로 무엇을 학습하는지 비판적으로 분석한 연구들입니다. 성능 경쟁을 넘어 모델의 작동 원리를 이해하려는 흐름이 뚜렷해지고 있음을 보여줍니다.
● Foundations without Fundamentals: Zero-Shot Blind Spots in Time Series FMs[14] - 스포트라이트로 선정된 발표로, 시계열 파운데이션 모델의 제로샷 성능에 존재하는 사각지대를 지적했습니다. LG AI연구원이 Tabular 데이터에서 발견한 레이블 시프트 취약점과 문제의식이 맞닿아 있습니다.
- 참고
[1] Hollmann, N. et al. "Accurate predictions on small data with a tabular foundation model." Nature, 2025.
[2] ICML 2026 Conference, Seoul, Korea, July 6-11, 2026. https://icml.cc/
[3] "Announcing the ICML 2026 Awards." ICML Blog, 2026. https://blog.icml.cc/2026/07/05/announcing-the-icml-2026-awards/
[4] Lee, S. "Mitigating Label Shift in Tabular In-Context Learning via Test-Time Posterior Adjustment." ICML, 2026. https://arxiv.org/abs/2605.04363
[5] Gotz, L., Kollovieh, M., Gunnemann, S., Schwinn, L. "Byte Pair Encoding for Efficient Time Series Forecasting." ICML, 2026. https://arxiv.org/abs/2505.14411
[6] Brachet, A.-R., Richard, P.-Y., Hudelot, C. "Time Series Forecasting Through the Lens of Dynamics." ICML, 2026. https://arxiv.org/abs/2507.15774
[7] Nguyen, M.H. et al. "Reviving Error Correction in Modern Deep Time-Series Forecasting." ICML, 2026. https://arxiv.org/abs/2605.21088
[8] Qiu, X., Yan, K., Liu, X., Wu, X., Hu, J. "Bridging Time and Frequency: A Joint Modeling Framework for Irregular Multivariate Time Series Forecasting." ICML, 2026. https://arxiv.org/abs/2602.00582
[9] 2nd ICML Workshop on Foundation Models for Structured Data (FMSD), 2026. https://icml-structured-fm-workshop.github.io/
[10] Thumm, D. et al. "Causal Foundation Models for Time Series based on Prior-Data Fitted Networks." ICML 2026 Workshop on FMSD, 2026.
[11] Roschmann, S. et al. "TiViT: Time Series Representations for Classification Lie Hidden in Pretrained Vision Transformers." ICML 2026 Workshop on FMSD, 2026.
[12] Rezaei Balef, A. et al. "Do Tabular Foundation Models Learn Rules or Memorize Exemplars?" ICML 2026 Workshop on FMSD, 2026.
[13] Cannistraci, I., Vogt, J.E. "Tabular Foundation Models Are Effectively Shallow." ICML 2026 Workshop on FMSD, 2026.
[14] Ghoroghchian, N. et al. "Foundations without Fundamentals: Zero-Shot Blind Spots in Time Series FMs." ICML 2026 Workshop on FMSD, 2026.