YSD_be400aed1.png Seungdong Yoa 2026.11.05

[ICLR2026] 정적 벤치마크를 넘어: LLM 추론 능력 평가를 위한 에이전트 중심의 동적 평가 프로토콜(ATAD)

최근 거대 언어 모델(LLM)은 빠른 속도로 발전하고 있습니다. MMLU[2], GSM8K[3]와 같은 기존의 벤치마크에서 모델들은 이미 인간의 능력을 능가하는 성능을 보여주기도 합니다. 그러나 이러한 고정형 벤치마크는 모델의 실제 추론 능력을 평가하는 데 점차 한계를 드러내고 있습니다. 또한 공개된 벤치마크가 대규모 사전학습 데이터에 포함되는 데이터 오염(Data Contamination), 특정 평가 형식에 대한 과적합 등의 문제도 지속적으로 제기되고 있습니다. 논문 역시 이러한 성능 포화, 데이터 오염, 벤치마크 수명의 한계를 Static Evaluation의 주요 문제로 제시합니다.


LG AI연구원은 이러한 문제를 해결하기 위해, 고정된 데이터셋을 평가하는 기존 방식에서 벗어나 평가 과정 자체가 모델의 능력에 맞춰 진화하는 동적 평가 프로토콜 ATAD(Agent-Centric Text Anomaly Detection)를 제안했습니다. ATAD는 Teacher, Orchestrator, Student로 구성된 세 개의 Agent가 문제를 생성하고, 검증하고, 해결하는 과정을 반복합니다. Student가 문제를 해결하면 Teacher는 더 어려운 문제를 만들고, Orchestrator는 그 과정에서 문제의 명확성·논리적 일관성·공정성을 지속적으로 검증해 난이도가 높아지면서 문제가 모호해지는 것을 방지합니다. 즉, ATAD의 핵심은 새로운 벤치마크 데이터셋을 한 번 구축하는 데 그치지 않고, 모델의 발전에 맞춰 평가 문제의 난이도와 품질을 지속적으로 조정하는 프로토콜을 제시했다는 점입니다.


관련 연구는 「From Static Benchmarks to Dynamic Protocol: Agent-Centric Text Anomaly Detection for Evaluating LLM Reasoning」이라는 제목으로 ICLR 2026 메인 컨퍼런스에 채택되어 발표되었습니다. ICLR (International Conference on Learning Representations)은 표현 학습과 딥러닝을 중심으로 머신러닝 분야의 최신 연구 성과가 공유되는 세계적인 국제 학술대회입니다. ICLR 2026은 4월 23일부터 27일까지 브라질 리우데자네이루에서 개최되었습니다.

1. 기존 정적 벤치마크의 한계와 새로운 모티베이션

현재 LLM 평가를 위해 널리 사용되는 정적(Static) 벤치마크들은 다음과 같은 구조적인 한계점들을 가지고 있습니다.

● 성능 포화(Performance Saturation): 최신 LLM들이 정적 벤치마크에서 이미 인간 수준의 성능을 뛰어넘어, 모델 간의 성능을 구분하는 변별력을 상실하고 있습니다.

● 데이터 오염(Data Contamination): 대규모 사전 학습 과정에서 평가 데이터가 포함되어 모델이 이를 암기하게 되고, 결과적으로 리더보드 점수가 부풀려지는 문제가 발생합니다.

● 포맷 과적합(Format Overfitting): 모델 개발자가 데이터셋의 특정 포맷에 맞춰 시스템을 튜닝하게 되어, 실제 범용적인 추론 능력의 향상 없이 점수만 높아지는 피드백 루프가 형성됩니다.

● 짧은 수명(Short Lifespan): 벤치마크가 한 번 정복되고 나면, 새로운 벤치마크를 구축하는 데 엄청난 시간과 자원이 소모되어 지속 가능한 평가가 어렵습니다.

이러한 문제들로 인해 데이터 오염을 방지하고 모델의 발전에 맞춰 지속적으로 진화할 수 있는 동적 평가(Dynamic Evaluation)의 필요성이 대두되었습니다.


하지만 기존의 동적 벤치마크들이 단순히 문제를 생성하거나 확장하는 수준에 머물렀다면, ATAD는 '에이전트 중심의 3자 상호작용 구조(Teacher-Orchestrator-Student)'를 도입하여 차별화를 꾀했습니다. 특히 오케스트레이터(Orchestrator)가 검증을 전담하여 난이도 상승 과정에서 발생할 수 있는 명확성(Clarity)의 저하와 모호성 증가를 방지하고, 학생 에이전트가 실패하는 지점을 포착하여 난이도를 정밀하게 최종화(Failure-Driven Sample Finalization)하는 메커니즘을 통해, 모델의 실질적인 맹점(Blind Spots)을 보다 정밀하게 드러내는 고품질 벤치마크 프로토콜을 완성했습니다.


특히 텍스트 이상 탐지(Text Anomaly Detection) 분야에서 문제를 만들 때, 연구자들은 항상 '명확성(Clarity)과 난이도(Difficulty) 간의 상충 관계(Trade-off)'라는 큰 난관에 부딪힙니다. 언어 특성상 수학이나 과학 도메인과 달리 명확한 수식이나 정해진 답이 존재하지 않기 때문에, 난이도를 높이려다 보면 문제의 정답이 모호해지고, 반대로 정답을 명확하게 만들면 문제가 너무 쉬워져 변별력을 잃는 현상이 발생하기 때문입니다.
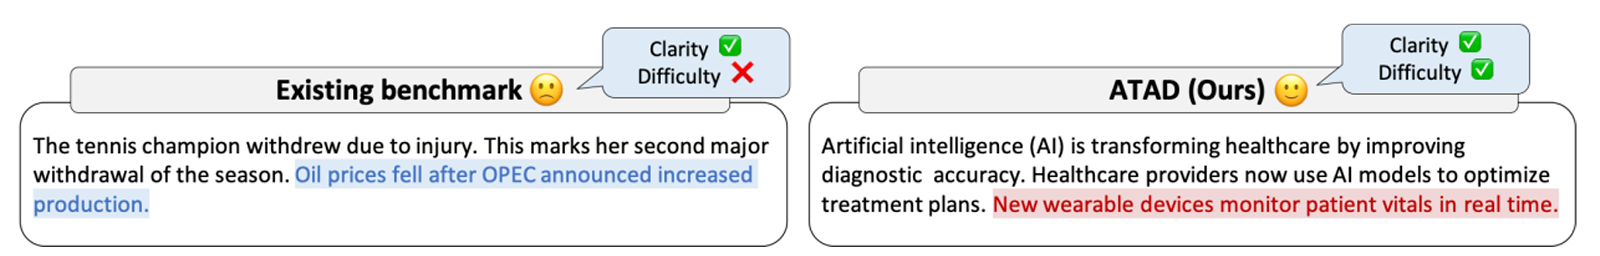


그림 1. 기존 벤치마크와 ATAD의 텍스트 이상 탐지 문제 비교[1]


예를 들어, 기존 벤치마크는 "테니스 챔피언이 부상으로 기권했다"는 문맥 사이에 완전히 뜬금없는 "OPEC 발표로 석유 가격이 하락했다"는 문장을 끼워 넣곤 합니다. 이는 정답이 명확하지만, 최신 LLM에게는 너무 쉬운(Trivial) 문제입니다.

반면 ATAD는 훨씬 정교합니다. "AI가 헬스케어를 혁신하고 있다"는 문맥 속에서, 치료 계획 최적화나 실시간 바이탈 모니터링 같은 기술적 혜택을 나열하다가, 갑자기 AI의 윤리적 문제를 제기하는 식의 미묘한 주제 전환을 유도합니다. 이를 통해 정답의 근거를 명확하게 유지하면서도, 고도의 언어적·논리적 추론 능력을 요구하는 까다로운 문제를 생성해냅니다.

2. ATAD 프로토콜 구조와 7가지 텍스트 이상 탐지 태스크
ATAD는 고정된 데이터셋 대신 3개의 AI 에이전트가 상호작용하는 프로토콜을 도입하여 이 문제를 해결합니다. 수학이나 코드와 달리 자연어는 명확한 공식이 없기 때문에, 텍스트 이상 탐지는 명확성을 유지하면서 난이도를 높일 수 있는지를 검증하기 위한 강력한 스트레스 테스트가 됩니다.

● Teacher Agent (출제자): 기본 문제를 생성하며, Student가 문제를 맞히면 그 분석을 바탕으로 점점 더 어려운 변형 문제를 생성합니다.
● Orchestrator Agent (검증자): 생성된 문제의 논리적 일관성, 명확성, 공정성을 엄격하게 검증하여 모호하거나 부적절한 적대적(Adversarial) 난이도 상승을 차단합니다.
● Student Agent (풀이자): 검증된 문제를 풉니다. Student가 문제를 틀리는 시점에서 해당 문제가 최종 벤치마크 항목으로 확정(Failure-Driven Sample Finalization)됩니다.
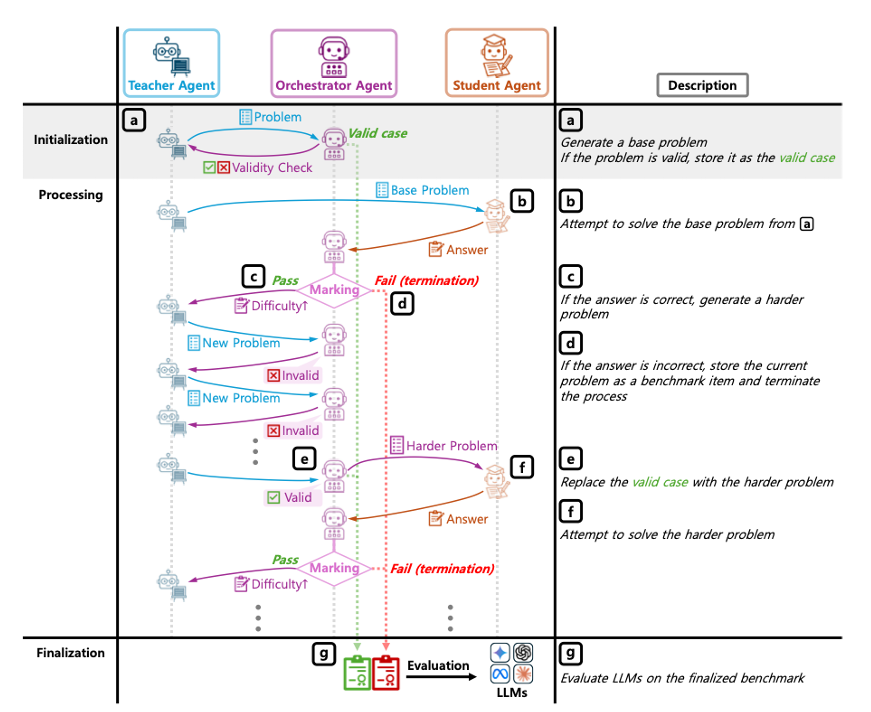

그림 2. ATAD의 Teacher-Orchestrator-Student 기반 동적 평가 프로토콜[1]


ATAD는 표면적인 패턴 매칭을 방지하고 교차 문장 간 논리적 추론(Cross-Sentence Logical Inference)을 평가하기 위해 총 7가지의 이상 탐지 태스크(T1~T7)를 설계했습니다.

대표적으로 문맥의 의미적 일탈을 찾는 문장 문맥 이상(T1: Sentence Context Anomaly), 지시어나 대명사의 모호성을 찾는 지시적 모호성(T5: Referential Ambiguity), 문체와 톤의 불일치를 찾는 톤/스타일 위반(T7: Tone/Style Violation) 등이 포함되어 있으며, 각 태스크는 모델의 다양한 추론 능력을 다각도로 검증합니다.
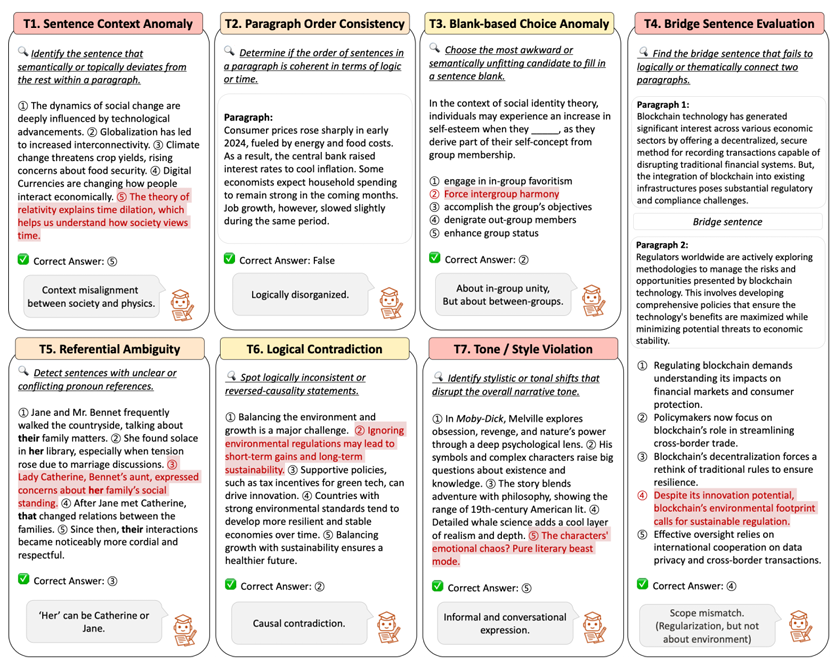

그림 3. ATAD에서 구성한 7가지 텍스트 이상 탐지 태스크의 예시[1]


3. 실험 결과 분석: 난이도 확장과 Orchestrator의 품질 관리 입증 
ATAD를 통해 생성된 벤치마크를 GPT-4o, Claude-3.5-Sonnet, Gemini-2.0-Flash 등 다양한 LLM들을 대상으로 평가한 결과, 흥미로운 사실들이 발견되었습니다.

첫째, 각 태스크별로 LLM의 성능 양상이 다르게 나타났습니다. 전체 평균에서는 상대적으로 높은 성능을 보이는 모델이라도 특정 태스크에서는 다른 모델보다 낮은 성능을 보였으며, 7개의 태스크 모두에서 일관되게 가장 높은 성능을 보이는 단일 모델은 존재하지 않았습니다. 이는 모델마다 문맥 이해, 논리적 연결, 지시 대상 추론, 문체 판단 등 서로 다른 추론 능력에서 고유한 강점과 취약점(Blind Spots)을 가지고 있음을 보여줍니다. 실제 실험에서도 Anomaly 유형에 따라 모델 간 성능 양상이 크게 달라졌습니다.
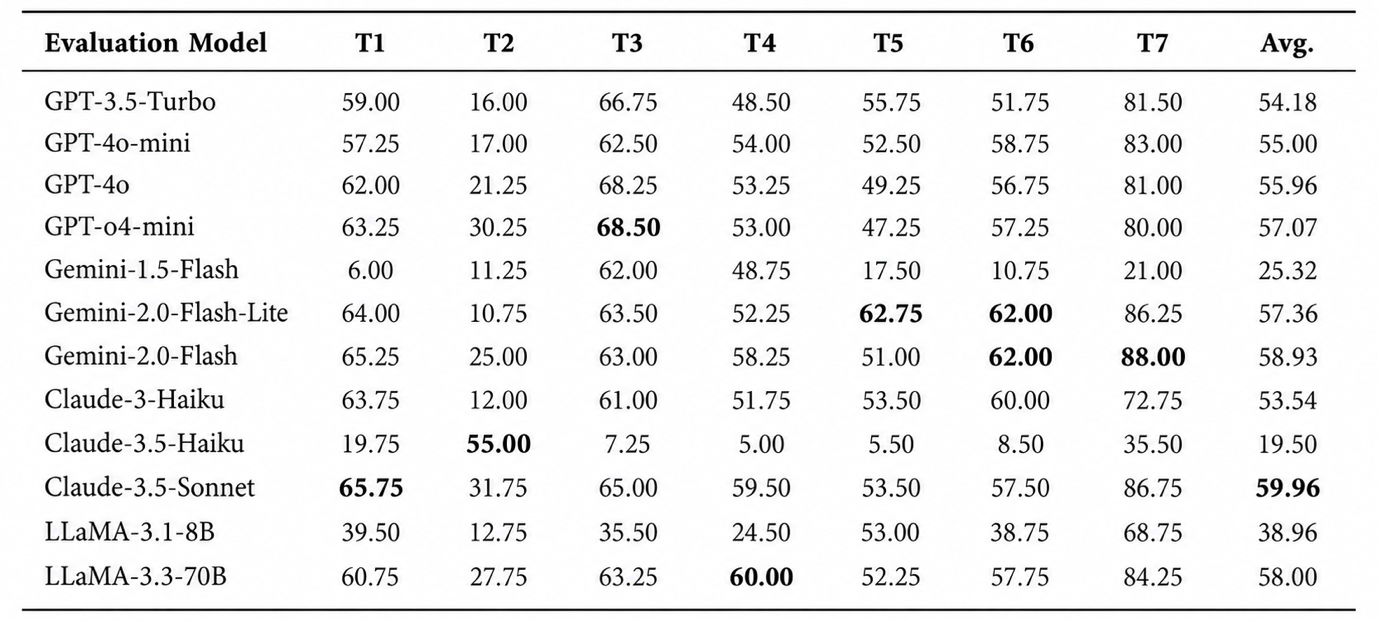

표 1. ATAD 벤치마크의 7가지 태스크에서 나타난 LLM별 성능 비교[1]
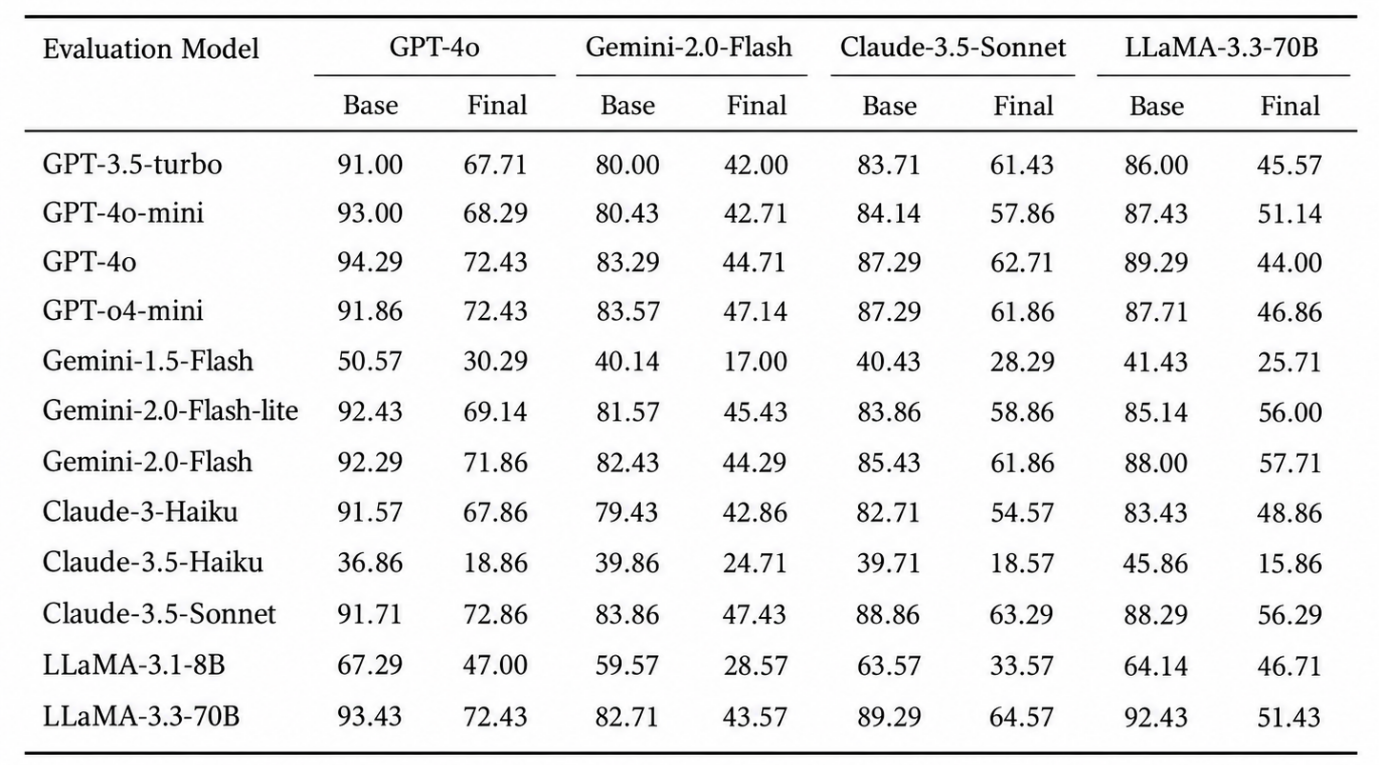

둘째, 모든 모델에서 Base(초기) 문제에 비해 Final(최종 확정) 문제의 정답률이 큰 폭으로 하락했습니다. 이는 ATAD 프로토콜이 Student가 이미 해결할 수 있는 문제에 머무르지 않고, Teacher-Student 간 반복적인 상호작용을 통해 실제로 더 어려운 문제를 만들어냈음을 의미합니다. GPT-4o, Gemini-2.0-Flash, Claude-3.5-Sonnet, LLaMA-3.3-70B를 각각 Benchmark Generation에 사용했을 때에도 Base에서 Final로 진행하면서 평가 정확도가 일관되게 감소했으며, 논문에서는 전체적으로 약 21.3~33.9%의 성능 감소가 관찰되었습니다.


표 2. Base problem과 ATAD를 통해 최종 생성된 Final problem에서의 LLM 성능 비교[1]
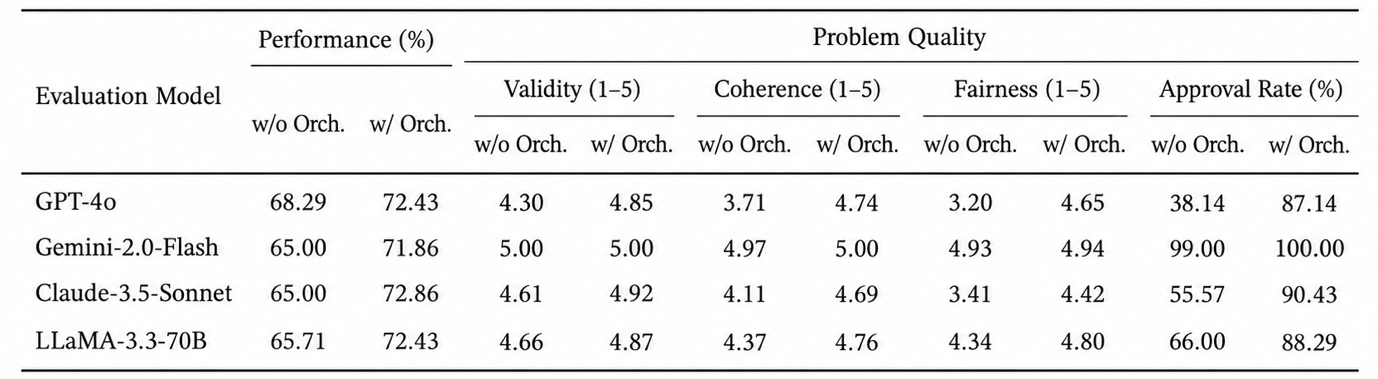

셋째, 가장 중요한 발견은 Orchestrator(검증자)의 품질 관리 역할에서 나타났습니다. 실험에서 Orchestrator를 제외하고 Teacher와 Student의 경쟁만으로 문제를 생성했을 때, GPT-4o의 평가 정확도는 68.29%로 Orchestrator가 개입했을 때의 72.43%보다 더 낮게 나타났습니다. 단순히 모델의 정답률만 본다면 Orchestrator가 없는 문제들이 더 어려운, 즉 더 좋은 Benchmark처럼 보일 수도 있습니다.

하지만 문제 자체의 품질을 함께 평가하면 다른 결과가 나타납니다. GPT-4o를 Reviewer로 사용했을 때 Orchestrator를 적용하면서 문제의 Validity는 4.30에서 4.85로, Coherence는 3.71에서 4.74로, Fairness는 3.20에서 4.65로 상승했습니다. 전체 문제 중 Benchmark로 사용하기 적절하다고 판단된 Approval Rate 역시 38.14%에서 87.14%로 크게 증가했습니다. Claude-3.5-Sonnet을 Reviewer로 사용했을 때에도 같은 경향이 관찰되었습니다.


표 3. Orchestrator 적용 여부에 따른 문제 난이도와 품질 비교[1]

즉, 모델이 많이 틀린다는 사실만으로 좋은 Benchmark라고 볼 수는 없습니다. 정답이 모호하거나 여러 답이 가능하고, 문제 자체에 논리적인 결함이 있어도 모델의 정답률은 낮아질 수 있기 때문입니다. 이런 경우 낮은 성능은 모델의 추론 한계를 보여주는 것이 아니라 잘못 설계된 문제로 인해 발생한 인위적인 난이도일 수 있습니다.

ATAD에서 Orchestrator는 바로 이 차이를 구분하는 역할을 합니다. Teacher가 더 어려운 문제를 생성하더라도 논리적 일관성, 명확성, 공정성이 유지되지 않으면 해당 문제를 Reject하고 다시 생성하도록 합니다. 따라서 ATAD는 단순히 모델의 정답률을 낮추는 것이 아니라, 좋은 문제라는 조건을 유지한 상태에서 추론 난이도를 높이는 것을 목표로 합니다. 논문에서도 Orchestrator가 없는 경우의 낮은 정확도가 실제 Reasoning Difficulty가 아니라 Ambiguous하거나 Ill-Posed된 문제에서 비롯될 수 있음을 확인했습니다.

이 결과는 앞서 설명한 Clarity와 Difficulty의 Trade-off와 직접 연결됩니다. Teacher-Student 경쟁은 문제의 Difficulty를 높이고, Orchestrator는 그 과정에서 Clarity가 무너지지 않도록 제어합니다. 두 역할을 분리함으로써 ATAD는 자연어 문제에서 어려운 문제와 좋은 문제를 동시에 만들어내는 것을 가능하게 합니다.


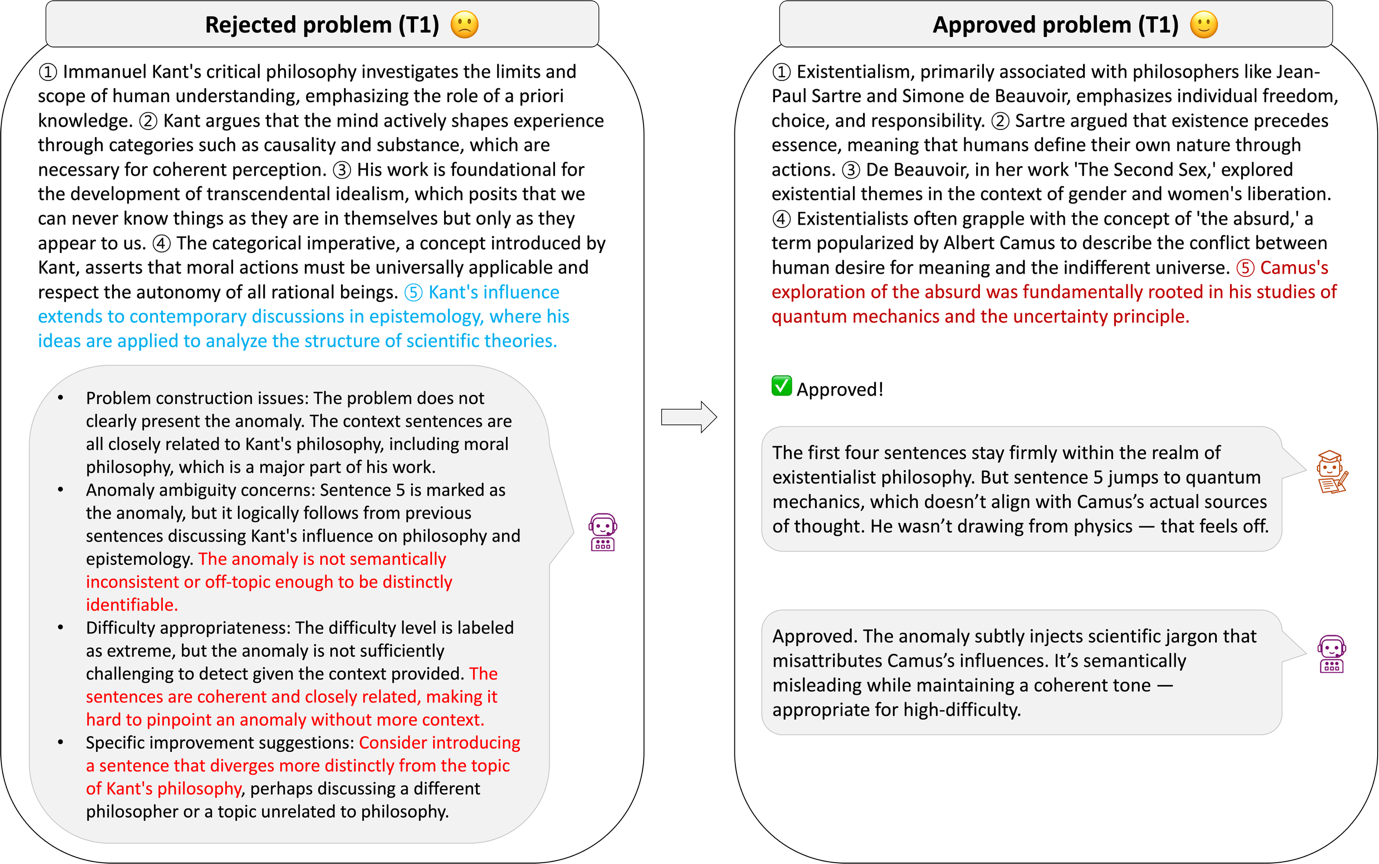
그림 4. Orchestrator 피드백을 통한 문제 개선 사례[1]

실제 사례에서도 이러한 역할을 확인할 수 있습니다. 그림 2에서 처음 생성된 문제는 문장들이 모두 주제와 어느 정도 관련되어 있어 어느 문장이 명확한 Anomaly인지 판단하기 어려웠습니다. Orchestrator는 이를 높은 난이도의 문제로 그대로 채택하는 대신, Anomaly가 충분히 명확하지 않다고 판단하여 문제를 Reject했습니다. 이후 Teacher가 피드백을 받아 문제를 다시 생성하면서, 전체 문맥과 자연스럽게 연결되면서도 분명한 의미적 오류를 포함하는 문제로 개선되었습니다.

이처럼 ATAD에서 Quality Control은 난이도를 낮추기 위한 장치가 아닙니다. 오히려 모호함에서 비롯된 잘못된 난이도를 제거하고, 실제 추론 능력을 요구하는 난이도만 남기기 위한 과정입니다.

4. 새로운 데이터셋이 아니라, 모델과 함께 진화하는 평가 프로토콜
ATAD가 궁극적으로 제안하는 변화는 단순히 하나의 새로운 Text Anomaly Detection 데이터셋을 추가하는 데 있지 않습니다. 기존 Static Benchmark에서는 평가 문제가 한 번 만들어지면 이후에도 동일한 문제가 반복적으로 사용됩니다. 따라서 모델이 발전하여 해당 Benchmark에서 높은 성능을 달성하기 시작하면, 시간이 지날수록 모델 간 능력 차이를 구분하기 어려워집니다.

반면 ATAD에서는 Benchmark를 고정된 데이터의 집합이 아니라 Teacher-Orchestrator-Student가 상호작용하는 하나의 프로토콜로 정의합니다. 현재 Student가 문제를 해결하면 Teacher가 더 어려운 문제를 생성하고, Orchestrator가 해당 문제가 여전히 명확하고 공정한지를 검증합니다. 따라서 더 강력한 모델이 등장해 Student의 역할을 수행하더라도 그 모델의 능력에 맞춰 평가 난이도를 다시 높일 수 있습니다.
이를 통해 Benchmark와 모델이 서로 독립적으로 존재하는 것이 아니라, 모델의 발전에 맞춰 Benchmark 역시 함께 진화하는 Model-Benchmark Co-evolution이 가능해집니다. 실제 논문에서도 기존의 Static Dataset 중심 평가에서 Dynamic Protocol 중심 평가로 시각을 전환하는 것이 ATAD의 핵심적인 연구 방향임을 강조합니다.

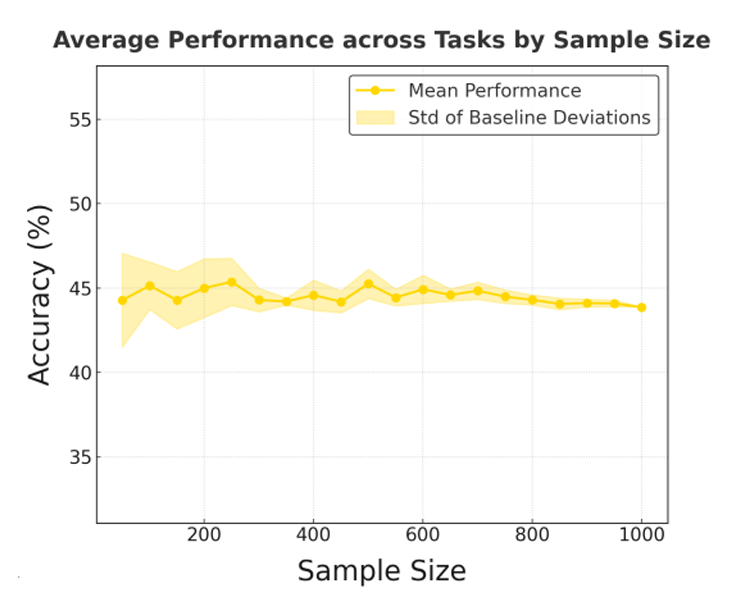
또한 동적으로 문제를 생성한다는 것이 평가 결과가 매번 크게 달라진다는 의미는 아닙니다. 동일한 Agent Configuration으로 반복해서 Benchmark를 생성하고 평가한 실험에서는 Sample 수가 증가하더라도 모델의 평균 성능이 비교적 안정적으로 유지되었습니다. 이는 ATAD가 모델의 능력에 맞춰 변화하면서도 평가 프로토콜로서 일정 수준의 일관성과 안정성을 유지할 수 있음을 보여줍니다.


그림 5. Benchmark Sample 수에 따른 평가 성능의 안정성[1]


결국 ATAD가 지향하는 것은 “더 어려운 데이터셋을 하나 더 만드는 것”이 아니라, 평가 대상인 AI가 발전함에 따라 평가 방식도 함께 발전할 수 있도록 만드는 것입니다.

향후 연구 방향: 스스로 진화하는 AI 평가 체계를 향해
이번 연구에서는 Text Anomaly Detection을 중심으로 ATAD의 가능성을 검증했습니다. Text Anomaly Detection은 수학이나 코드와 달리 명확한 공식이나 실행 결과를 이용해 답을 검증하기 어려우면서도, 문맥·논리·지시 관계·스타일 등 다양한 형태의 Reasoning을 동시에 요구합니다. 따라서 난이도를 높이면서도 문제의 명확성을 유지할 수 있는가를 검증하기 위한 까다로운 환경이었습니다. 논문에서도 이러한 특성 때문에 Text Anomaly Detection을 ATAD의 대표적인 Stress Test로 사용했습니다.

그러나 ATAD의 Teacher-Orchestrator-Student 구조 자체는 특정 태스크에 종속되어 있지 않습니다. 향후에는 이를 수학적 추론, 코드 검증, Tool-Use, Multimodal Reasoning 등 보다 다양한 영역으로 확장할 수 있습니다. 또한 Teacher에게 외부 문서나 지식을 제공하여 Domain-Specific 문제를 생성하거나, Orchestrator에 Retrieval-Augmented Generation(RAG) 또는 별도의 Verifier를 결합하여 사실적 정확성과 논리적 타당성을 보다 정교하게 검증하는 방향도 고려할 수 있습니다.

더 나아가 현재는 사람이 Teacher, Student, Orchestrator라는 역할과 Workflow를 설계하지만, 향후에는 Meta-Agent를 활용해 더 좋은 Teacher와 Orchestrator 자체를 자동으로 탐색하거나 Agent 간 역할과 Interaction을 최적화할 수도 있습니다. 이를 통해 평가 문제뿐 아니라 평가를 만드는 Agent와 평가 프로토콜 자체가 함께 진화하는 시스템으로 발전할 수 있습니다. 논문에서는 Agent의 기여도를 Game-Theoretic하게 분석하거나, Meta-Agent를 통해 더 효과적인 Agent Workflow를 자동 탐색하는 방향도 후속 연구로 제시했습니다.

궁극적으로 LG AI연구원은 모델이 발전할 때마다 새로운 Benchmark를 처음부터 다시 구축하는 평가 방식에서 벗어나, AI의 능력에 따라 문제의 난이도와 평가 방법이 지속적으로 적응하는 동적 평가 체계로 연구를 확장하고자 합니다. 모델의 최종 점수 하나만 비교하는 것을 넘어, 모델이 어떤 Reasoning 능력을 갖추고 있으며 어느 지점에서 실패하는지를 지속적으로 탐색할 수 있는 평가 방법을 구축하는 것이 목표입니다.

이번 ICLR 2026에서 ATAD 연구를 발표하며, LLM의 빠른 발전에 맞춰 평가 방법 역시 함께 진화해야 한다는 문제의식을 공유했습니다. 앞으로도 Agent 간 상호작용을 활용하여 모델의 능력과 한계를 보다 정교하게 측정하고, 새로운 AI가 등장하더라도 지속적으로 유효한 평가 방법을 연구해 나갈 예정입니다.

참고

[1] Seungdong Yoa, Sanghyu Yoon, Suhee Yoon, Dongmin Kim, Ye Seul Sim, Junhyun Lee*, Woohyung Lim*. From Static Benchmarks to Dynamic Protocol: Agent-Centric Text Anomaly Detection for Evaluating LLM Reasoning. In International Conference on Learning Representations (ICLR), 2026.

[2] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, Jacob Steinhardt. Measuring Massive Multitask Language Understanding. In International Conference on Learning Representations (ICLR), 2021.

[3] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, Christopher Hesse, John Schulman. Training Verifiers to Solve Math Word Problems.