YSD_be400aed1.png Seungdong Yoa 2026.11.17

[ICML2026] 신뢰도 기반 적응형 토론을 통한 효율적인 멀티에이전트 추론

2026년 7월 6일부터 11일까지 서울 코엑스에서 제43회 International Conference on Machine Learning(ICML 2026)이 개최되었습니다. ICML은 머신러닝 이론부터 인공지능, 통계, 데이터 사이언스와 다양한 응용 분야를 폭넓게 다루는 대표적인 국제 머신러닝 학회입니다. 올해 ICML은 서울에서 개최되어 전 세계 연구자들이 한자리에 모여 최신 머신러닝 연구 결과를 공유했습니다.
 
최근 Large Language Model(LLM)의 추론 능력이 빠르게 발전하면서, 하나의 모델이 혼자 문제를 해결하는 것을 넘어 여러 AI Agent가 서로의 답변을 검토하고 토론하며 더 나은 답을 만들어내는 Multi-Agent Reasoning이 활발하게 연구되고 있습니다. 특히 Multi-Agent Debate(MAD)는 여러 Agent가 서로 다른 관점에서 답을 생성하고, 비판하고, 수정하는 과정을 반복함으로써 단일 Agent의 오류를 보완할 수 있다는 직관적인 장점을 가지고 있습니다.
 
하지만 여기에는 한 가지 중요한 질문이 있습니다.
“Agent를 더 많이 투입하고 더 오래 토론하면 정말 항상 더 좋은 답을 얻을 수 있을까?”
 
토론이 길어질수록 Agent 호출 횟수와 Token 사용량은 빠르게 증가합니다. 더 중요한 것은 최근 이론 연구들조차 Multi-Agent Debate가 실제로 도움이 되는지에 대해 서로 상반되어 보이는 결론을 내리고 있다는 점입니다. LG AI연구원은 ICML 2026에서 발표한 “Efficient Multi-Agent Reasoning via Confidence-Guided Adaptive Debate” 연구를 통해 이 문제를 다시 살펴보고, 토론의 효과를 결정하는 핵심이 단순히 Agent의 수가 아니라 “언제(When) 토론하고, 어떻게(How) 토론하는가”에 있다는 관점을 제안했습니다. 논문은 이를 바탕으로 LASE(Leader-Adaptive Structured Engagement)[1]라는 효율적인 Multi-Agent Reasoning Framework를 제안합니다.


1. 연구의 계기: “많이 토론하면 더 좋아질까?”

사람들의 회의를 생각해보면 Multi-Agent Debate의 문제를 조금 더 쉽게 이해할 수 있습니다.

명확한 방향이나 역할 없이 모든 사람이 처음부터 자유롭게 의견을 주고받는 회의는 시간이 오래 걸리는 것에 비해 반드시 좋은 결론으로 이어지지는 않습니다. 반면 누군가가 문제 해결에 중요한 아이디어를 제시하면, 이후의 토론은 그 아이디어를 검증하고 발전시키며 훨씬 생산적인 방향으로 진행될 수 있습니다.

즉, 토론 자체가 중요한 것이 아니라 토론에 유용한 정보가 존재하는지, 그리고 그 정보를 어떻게 활용하도록 토론을 구성하는지가 중요할 수 있습니다. 발표에서는 이를 “Correct Seed Scenario”와 “Neutral Scenario”로 설명했습니다. 유효한 아이디어, 즉 Correct Seed가 존재하는 경우에는 상호작용이 이를 증폭시킬 수 있지만, 특별히 새로운 신호가 없는 상태에서 동등한 Agent들이 계속 정보를 교환한다면 토론이 제자리걸음을 할 수도 있습니다.

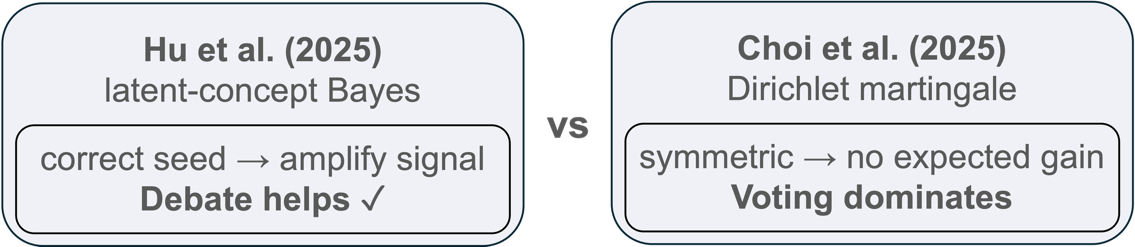
실제로 최근 Multi-Agent Debate의 이론을 연구한 두 연구는 언뜻 보면 정반대의 결론을 제시합니다.

Debate는 도움이 될까, 아닐까? 서로 다른 두 이론
첫 번째는 Hu et al. (2025)[2]의 관점입니다.

이 연구는 Multi-Agent Debate를 Latent Concept에 대한 Bayesian Inference 과정으로 바라봅니다. 여러 Agent의 응답 중 실제 정답에 해당하는 Latent Concept과 강하게 일치하는 “Correct Seed”가 존재한다면, 다른 Agent들이 이 응답을 관찰하며 Posterior를 업데이트하는 과정에서 올바른 신호가 점차 증폭될 수 있습니다. 이 조건에서는 반복적인 Interaction이 Correctness를 증가시키며, 일정한 가정하에서는 최종 Debate 결과가 Majority Voting보다도 높은 정확도를 가질 수 있음을 보였습니다.

반면 Choi et al. (2025)[3]은 다른 관점에서 Multi-Agent Debate를 분석합니다.

Agent들이 서로 비슷한 Belief를 가지고 대칭적으로 정보를 교환한다고 가정하면, 각 Agent의 Belief Update는 Martingale을 형성할 수 있습니다. 다시 말해 Agent들 사이에서 정보가 계속 이동하고 섞이기는 하지만, 평균적으로 정답 방향으로 이동하는 Positive Drift가 발생하지 않습니다. 따라서 이러한 Symmetric Regime에서는 복잡한 Debate를 수행해도 기대 정확도가 증가하지 않으며, 독립적인 답변들을 마지막에 Majority Voting하는 것이 더 효율적일 수 있습니다.

표면적으로 보면 두 연구는 정반대의 이야기를 하는 것처럼 보입니다.

● Hu et al.: Correct Seed가 있다면 Debate가 올바른 신호를 증폭시킨다.
● Choi et al.: Symmetric Debate는 기대값을 개선하지 못하며 Voting이면 충분하다.

하지만 저희는 두 결과가 실제로 모순되는 것이 아니라, 서로 다른 Interaction Regime을 설명하고 있다고 보았습니다.

Correct Seed와 같이 유용한 비대칭적 정보가 존재한다면 Debate는 Corrective Regime으로 작동합니다. 반대로 Agent들이 동일한 위치에서 대칭적으로 정보를 주고받는다면 Debate는 기존 정보를 재분배하는 Neutral Regime에 머무를 수 있습니다. 따라서 중요한 질문은
“Debate가 좋은가, 나쁜가?”가 아니라
“언제 Debate를 시작해야 하고, 어떤 구조로 Debate해야 하는가?”
입니다.
이것이 이번 연구의 출발점입니다. 논문에서는 두 이론을 이러한 Neutral Regime과 Corrective Regime으로 통합해 해석하고, Positive Drift를 만들기 위해서는 Symmetry를 의도적으로 깨뜨리는 구조적 개입이 필요하다고 정리했습니다.


2. 주요 연구 내용
1) When: 필요한 순간에만 토론한다
기존 Multi-Agent Debate는 대체로 문제의 난이도나 현재 Agent의 상태와 관계없이 모든 문제에서 여러 Agent를 호출합니다. 하지만 이미 Leader가 확신을 가지고 올바르게 풀 수 있는 문제까지 굳이 여러 Agent가 다시 검토한다면 성능 향상보다 Token Cost만 증가할 가능성이 높습니다.

LASE는 따라서 항상 Multi-Agent Reasoning을 시작하지 않습니다.

먼저 하나의 Leader Agent가 혼자 문제를 해결합니다. 이후 생성한 답변에 대한 모델 내부의 uncertainty를 측정합니다. 구체적으로 답변 토큰들 가운데 가장 낮은 Log Probability인 Min Logprob와 가장 높은 분포 Entropy인 Max Entropy를 이용합니다. Leader의 Confidence가 충분하다면 여기에서 바로 추론을 종료하며, Supporter Agent는 호출되지 않습니다.
반대로 Confidence가 낮거나 Ambiguity가 높다고 판단되는 경우에만 Uncertainty Event (U=1)이 발생하고 Multi-Agent Interaction이 시작됩니다.

즉, 계산 자원을 모든 문제에 동일하게 사용하는 대신, 추가적인 도움이 필요할 가능성이 높은 문제에 선택적으로 할당합니다.

2) How: 모두가 동등하게 토론하지 않는다
두 번째 핵심은 Interaction의 구조 자체를 비대칭적으로 설계했다는 것입니다.

일반적인 Multi-Agent Debate에서는 여러 Agent가 서로의 답변을 보고 반복적으로 수정하는 All-to-All 구조가 흔히 사용됩니다. 하지만 앞서 살펴본 것처럼 Homogeneous Agent들이 서로를 대칭적으로 관찰하는 구조에서는 Information Mixing만 발생하고, 정답 쪽으로의 Systematic Drift가 발생하지 않을 수 있습니다.

LASE에서는 하나의 Leader가 전체 Reasoning Trajectory와 최종 의사결정을 계속 유지합니다. Supporter는 Leader와 동등한 의사결정자가 아니라, Leader가 잘못된 Reasoning Path에서 벗어날 수 있도록 Targeted Auxiliary Signal을 제공하는 역할을 담당합니다.

Leader가 불확실할 경우 Supporter는 한 번에 하나씩 다음과 같이 단계적으로 개입합니다.

Adversarial Check (Devil's Advocate)는 Leader의 논리적 약점과 Hidden Assumption을 공격하고, Peer Support는 막힌 지점에 Alternative Perspective나 Hint를 제공하며, 그래도 Uncertainty가 지속될 경우 Expert Agent가 놓치고 있는 핵심 개념이나 Insight를 지적합니다. 각 단계 후 Leader의 Confidence가 회복되면 즉시 Interaction을 종료합니다.

이러한 구조에서는 모든 Agent가 서로 대화하는 대신 Leader ↔ Supporter의 1:1 Directed Star Topology가 형성됩니다.

즉 LASE의 두 질문은 명확합니다.

● WHEN - Leader가 불확실한 경우에만 Debate를 시작한다.
● HOW - 모든 Agent가 동등하게 토론하는 대신 Leader 중심의 Asymmetric Interaction으로 Debate를 구조화한다.
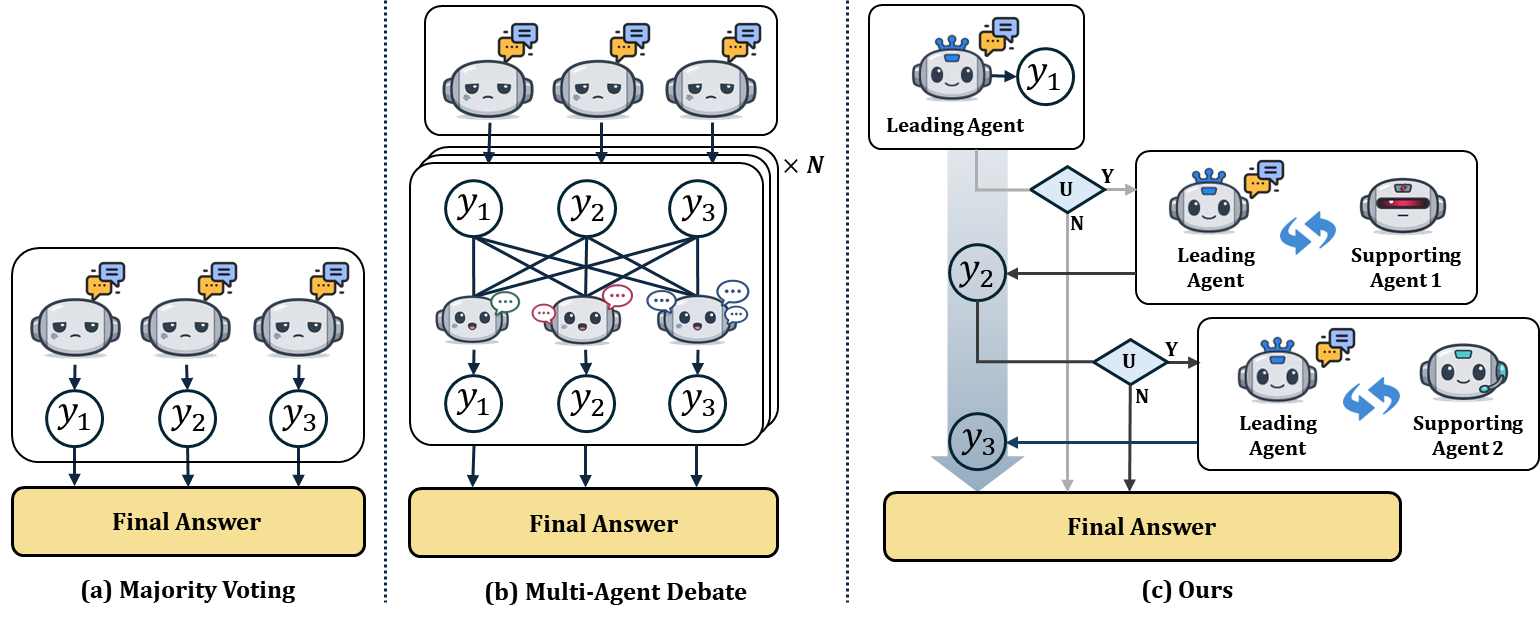

그림 1. Majority Voting, 기존 Multi-Agent Debate, LASE의 전체 구조 비교. LASE는 Leader가 불확실한 경우에만 Leader 중심의 비대칭적 상호작용을 선택적으로 수행함[1]
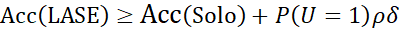

3) 두 이론을 연결하면 무엇을 보장할 수 있을까?
이번 연구에서는 이러한 설계가 단순한 Heuristic에 그치지 않도록 앞서 살펴본 두 이론과 연결해 분석했습니다.

먼저 Proposition 3.2에서는 LASE가 Choi et al.이 Martingale Neutrality를 도출할 때 필요한 Symmetry Condition을 깨뜨린다는 점을 보였습니다.

LASE에서는 모든 Agent가 서로의 정보를 평균적으로 받아들이는 것이 아니라 Leader만 Supporter의 정보를 받아들이며, interaction 자체도 Leader가 불확실한 경우에만 선택적으로 실행됩니다. 따라서 Leader의 Belief가 주변 Agent들의 평균 Belief와 같아야 한다는 Symmetric Averaging Condition이 구조적으로 보장되지 않습니다. 결과적으로 기존 Symmetric Debate에서 성립했던 Martingale Neutrality를 LASE에 그대로 적용할 수 없습니다.

그 다음 Theorem 3.7에서는 Hu et al.의 Correct Seed Amplification 관점을 연결했습니다.

Leader가 불확실한 문제에서 Supporter가 Correct Seed를 제공할 확률을 ρ, Correct Seed를 관찰했을 때 Correctness가 증가하는 정도를 δ라고 하면, 논문에서 정의한 조건하에서 LASE는 다음과 같은 Expected Accuracy Bound를 갖습니다.


즉 불확실한 상황에서 유용한 Corrective Signal을 얻을 가능성이 존재하고, 그 Signal이 Leader의 추론을 개선하며, 유용한 Seed가 없을 때 기존 답변을 해치지 않는다는 조건하에서는, Selective Debate가 Single-Agent Reasoning 대비 양의 Expected Gain을 보장합니다.

여기서 중요한 점은 단순히 “Agent를 많이 사용하기 때문에 좋아진다”가 아니라는 것입니다.

유용한 Interaction이 발생할 조건을 선택하고, 그 Interaction이 정답 방향으로 작동할 수 있도록 구조를 설계했기 때문에 개선될 수 있다는 것이 핵심입니다.

비용 측면에서도 차이가 있습니다. 일반적인 All-to-All Debate에서는 n개의 Agent가 T번 토론할 경우 Cross-Agent Context Interaction이 Θ(Tn^2 )까지 증가할 수 있습니다. 반면 LASE처럼 한 번에 소수의 Supporter와 Leader만 상호작용하는 구조에서는 이를 O(T) 수준으로 제한할 수 있습니다. 논문에서는 이를 바탕으로 Stated Assumptions 하에서 항상 Interaction하는 방식보다 낮은 비용으로 Single Agent보다 높은 Expected Accuracy를 갖는 Pareto Improvement도 정리했습니다.

실험 결과: Debate를 줄였는데 오히려 더 잘 풀었다
LASE의 효과를 검증하기 위해 Gemini-2.0-Flash와 GPT-4.1-mini를 이용해 수학적 추론, Symbolic Reasoning, 전문 지식, Factual Robustness를 포함한 여섯 개 Benchmark에서 실험했습니다. 비교 대상은 Single Agent, Majority Voting(MV), 그리고 기존 Multi-Agent Debate(MAD)입니다.

결과의 핵심은 간단합니다.

Multi-Agent 수준의 정확도를 유지하거나 그 이상으로 향상시키면서도, Token Cost는 Single Agent에 가까운 수준으로 줄일 수 있었습니다.
예를 들어 Gemini-2.0-Flash의 MATH-500에서는 Single Agent가 80.0%, Majority Voting이 86.4%, 기존 MAD가 74.8%의 정확도를 보인 반면, LASE는 87.2%를 기록했습니다. 평균 Token 사용량은 LASE가 1.1k로, Majority Voting의 5.2k와 MAD의 11.8k에 비해 크게 적었습니다.

GSM-Symbolic에서도 Single Agent 88.4%, MV 91.2%, MAD 88.6% 대비 LASE는 93.4%를 기록했으며, 평균 Token은 0.4k로 Single Agent와 사실상 같은 수준이었습니다. GPQA-Diamond에서도 Gemini 기반 LASE는 Single Agent의 61.6%에서 65.2%로 성능을 높이면서 MAD의 17.2k 대비 1.2k Token만 사용했습니다. 전체 Table 1에서 두 Backbone과 여섯 Benchmark의 모든 조합에서 LASE는 해당 Single-Agent Baseline보다 높은 정확도를 기록했습니다.
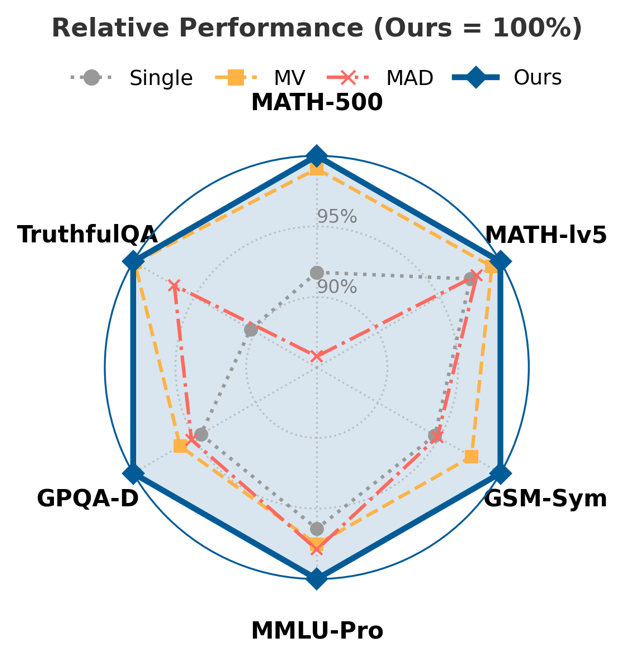
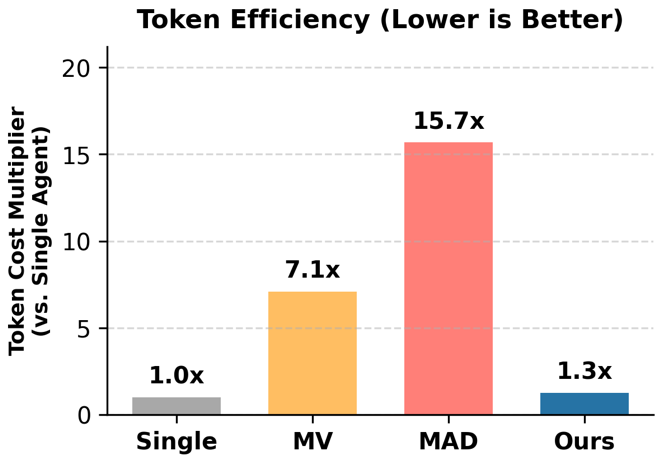

그림 2. LASE의 성능 및 효율성 개요. 좌측은 각 방식의 상대적인 성능을, 우측은 Single Agent 대비 Token Cost를 보여줌[1]
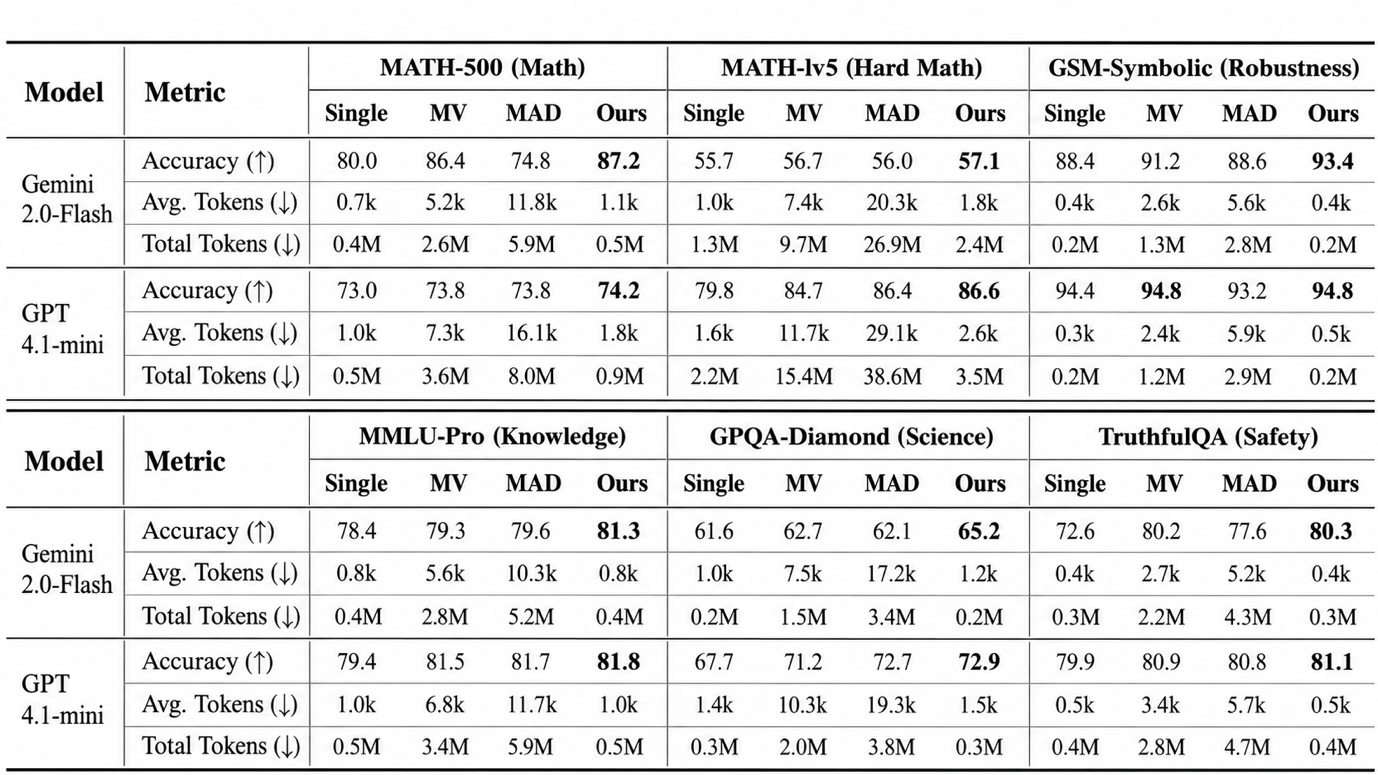

표 1. 다양한 Reasoning Benchmark에서의 성능 및 Token Cost 비교[1]


Debate와 Voting은 경쟁 관계일까?
또 한 가지 흥미로운 결과는 LASE가 Majority Voting과 배타적인 방법이 아니라는 점입니다.

LASE 자체가 하나의 더 나은 Reasoning Path를 만드는 방법이라면, 이렇게 생성된 여러 Reasoning Path를 다시 Majority Voting할 수도 있습니다.

MATH-500에서 일반적인 Majority Voting은 7개의 독립 응답을 사용해 5.2k Token으로 86.4%의 정확도를 기록했습니다. 반면 LASE 단일 실행은 1.1k Token으로 87.2%를 기록했고, LASE를 5번 실행한 뒤 Majority Voting한 경우에는 비슷한 5.4k Token으로 88.0%까지 성능이 높아졌습니다.

즉, LASE는 Voting을 없애는 방식이라기보다는 Voting에 들어가는 각각의 Reasoning Path 자체를 더 신뢰할 수 있게 만드는 “Better Voter”로도 활용될 수 있습니다.
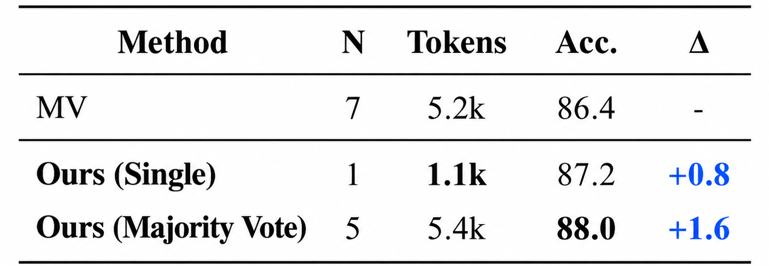

표 2. LASE와 Majority Voting의 호환성[1]


정말 uncertainty가 높을 때 Agent의 도움이 더 필요할까?
LASE에서 중요한 전제 중 하나는 모델 자신의 Confidence가 “언제 추가적인 도움을 요청해야 하는가”를 판단하는 유용한 신호여야 한다는 것입니다.

이를 확인하기 위해, Leader의 Uncertainty를 측정하는 두 Confidence Proxy인 Min Logprob와 Entropy가 실제 정답률과 얼마나 일관되게 연결되는지 Calibration(캘리브레이션) 분석을 수행했습니다. 분석 결과, Min Logprob가 높은, 즉 모델이 높은 Confidence를 보인 구간에서는 높은 정확도를 보였지만 Confidence가 낮아질수록 정확도도 감소했습니다. 반대로 Entropy가 높아져 예측 분포가 불확실해질수록 정답률 역시 크게 감소했습니다.


예를 들어 Min Logprob가 0.99 이상인 구간의 정확도는 85.5%였지만 0.50 미만에서는 50.9%까지 감소했고, Entropy가 1.0보다 높은 구간에서는 정확도가 30.4%까지 떨어졌습니다. 이는 LASE의 Uncertainty Gate가 단순히 임의로 계산 자원을 줄이기 위한 장치가 아니라, 실제로 오류 가능성이 높은 문제를 구분하는 신호로 작동한다는 것을 보여줍니다.
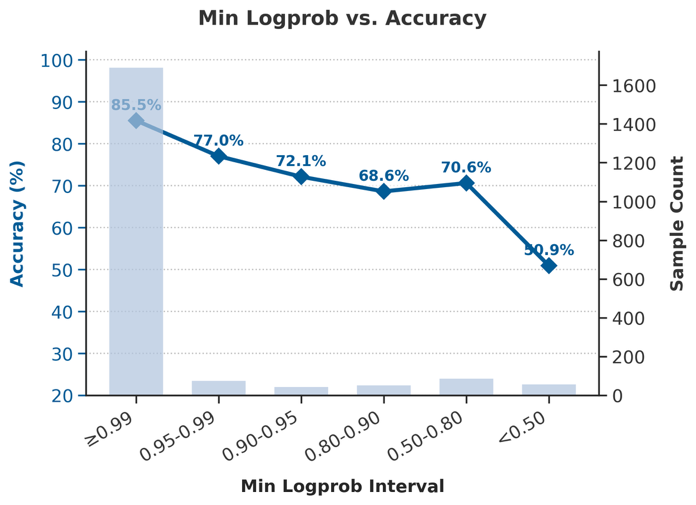
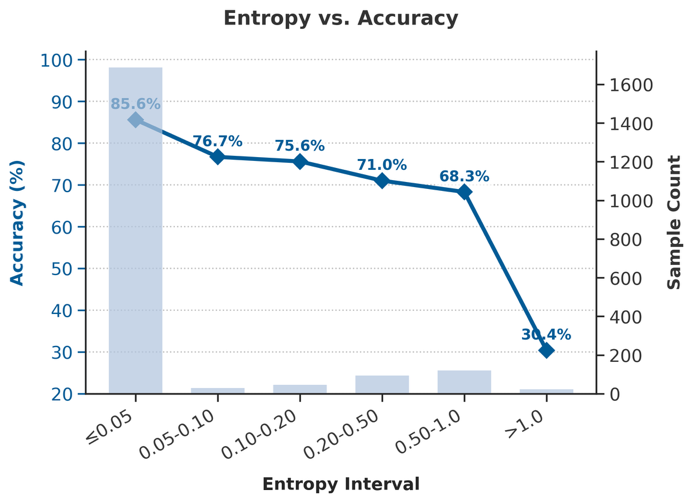
그림 3. Confidence Proxy의 Calibration 분석. 낮은 Min Logprob와 높은 Entropy로 측정된 Uncertainty가 커질수록 실제 정확도가 감소하는 경향을 보임[1]

“토론을 많이 한다”보다 중요한 것
이러한 현상은 작은 Open-Weight Model에서도 확인할 수 있었습니다.

Llama-3-8B를 MATH-500에 적용했을 때 Single Agent는 25.7%, Majority Voting은 31.8%의 정확도를 기록했지만, 기존의 Symmetric Multi-Agent Debate는 오히려 24.1%로 Single Agent보다 낮은 성능을 보였습니다.

반면 LASE는 32.9%로 가장 높은 정확도를 기록하면서, 전체 Token 사용량도 MV의 2.0M, MAD의 4.4M보다 적은 1.4M으로 유지했습니다. 이 결과는 특히 Base Model의 능력이 제한적인 상황에서는 여러 Agent가 대화를 많이 한다고 해서 정답이 자연스럽게 만들어지는 것이 아니며, 잘못된 정보가 대칭적인 Interaction을 통해 반복적으로 강화될 수도 있음을 보여줍니다.

결국 이번 연구가 전달하고자 하는 메시지는 “Debate가 중요하지 않다”가 아닙니다.

오히려 그 반대입니다.

Debate는 강력한 Reasoning Tool이 될 수 있지만, 그 효과는 언제 사용하고 어떻게 구조화하느냐에 달려 있습니다.
무조건 Agent를 늘리고 Interaction을 반복하는 대신, 도움이 필요한 순간을 판단하고, 그 순간에 정답 방향의 Corrective Signal이 만들어질 수 있도록 Interaction을 설계해야 합니다.

3. LG AI연구원의 향후 계획 
이번 연구에서는 Multi-Agent Debate가 효과적으로 작동하기 위한 최소한의 구조에 집중했습니다. 하나의 Leader가 전체 Reasoning Trajectory를 유지하고, 필요할 때 한 명의 Supporter가 단계적으로 개입하는 비교적 단순한 구조만으로도 Symmetric Debate의 한계를 벗어나면서 높은 Accuracy-Efficiency Trade-Off를 달성할 수 있음을 확인했습니다.
 
앞으로는 Supporter 자체를 보다 풍부하게 확장할 수 있습니다. 예를 들어 하나의 Supporter 대신 작은 Agent Ensemble을 사용하거나, 여러 Supporter가 먼저 서로 토론해 하나의 Robust한 Signal을 만들어 Leader에게 전달하는 Hierarchical Multi-Agent Structure로 발전시킬 수 있습니다. 이 경우에도 전체 Reasoning의 Control은 Leader에게 유지하면서, 더 어려운 문제에서 보다 강한 Corrective Signal을 제공하는 방향을 고려할 수 있습니다.
 
또한 현재의 Min Logprob나 Entropy보다 더 정교한 Uncertainty Signal도 중요한 연구 방향입니다. 특히 모델이 틀린 답을 높은 Confidence로 생성하는 Confident Error는 현재 방식으로는 Interaction을 Trigger하지 못할 수 있습니다. 향후 Semantic Uncertainty, Process-Level Verification, Process Reward Model(PRM) 등을 활용해 모델의 추론 과정 자체에서 보다 안정적으로 오류 가능성을 탐지할 수 있다면, “언제 추가적인 Reasoning Resource를 사용할 것인가”를 더욱 정확하게 결정할 수 있을 것입니다. 발표 자료에서도 이러한 Uncertainty Proxy의 고도화를 주요 Future Direction으로 제시했습니다.
 
LG AI연구원은 앞으로도 단순히 더 많은 계산량과 더 많은 Agent를 사용하는 방향이 아니라, 필요한 순간에 필요한 형태의 Intelligence를 선택적으로 사용함으로써 더 효율적이고 신뢰할 수 있는 Agentic Reasoning을 구현하는 연구를 이어가고자 합니다.

참고

[1] Seungdong Yoa, Ye Seul Sim, Suhee Yoon, Sanghyu Yoon, Dongmin Kim, Soonyoung Lee, Bumsoo Kim*, Junhyun Lee*. Efficient Multi-Agent Reasoning via Confidence-Guided Adaptive Debate. Proceedings of the 43rd International Conference on Machine Learning (ICML), 2026.

[2] Tianyu Hu, Zhen Tan, Song Wang, Huaizhi Qu, Tianlong Chen. Multi-Agent Debate for LLM Judges with Adaptive Stability Detection. Advances in Neural Information Processing Systems (NeurIPS), 2025.

[3] Hyeong Kyu Choi, Xiaojin Zhu, Sharon Li. Debate or Vote: Which Yields Better Decisions in Multi-Agent Large Language Models? Advances in Neural Information Processing Systems (NeurIPS), 2025.